Промпты для ABC- и RFM-анализа полезны не потому, что чат способен проглотить любую выгрузку и мгновенно посчитать сегменты. Его сильная сторона другая: помочь выбрать методику, заметить неоднозначные поля, написать SQL, формулы или Python-код, а затем объяснить небольшую таблицу с итогами.
В чат-режиме Agent Roi нет подключения к CRM, базе данных и Excel, а код не запускается автоматически. Поэтому рабочий процесс выглядит так: вы описываете данные и правила, чат готовит расчёт, вы выполняете его в своей системе, проверяете контрольные суммы и возвращаете обезличенные агрегаты для интерпретации.
Ниже — готовые промпты, системный промпт и примеры ответов для такого сценария. Их можно адаптировать под продажи, ассортимент, клиентов или услуги.
Что реально может чат в ABC- и RFM-анализе
ABC-анализ ранжирует выбранные объекты по вкладу в показатель. Например, товары можно отсортировать по выручке или марже, рассчитать долю каждого товара и накопленную долю, а затем присвоить классы A, B и C. В актуальной документации Microsoft класс также определяется через накопленный процент продаж и настраиваемые границы — единственных обязательных порогов для всех компаний нет. Подробнее этот принцип описан в метриках ABC Classification.
RFM-анализ работает с клиентами и отвечает на три вопроса:
- Recency: как давно клиент совершил последнюю покупку;
- Frequency: сколько покупок он совершил за выбранный период;
- Monetary: сколько денег принесли эти покупки.
Так RFM определяет и Oracle. Баллы 1–5 удобны, но это не закон природы. В Dynamics 365, например, можно выбрать число групп, равное распределение клиентов, веса показателей, валовую или чистую сумму и правило учёта возвратов. Значит, чат не должен выбирать эти настройки молча — он обязан сначала спросить о бизнес-правилах. Возможные параметры собраны в документации Microsoft по RFM.
В обычном чате можно:
- проверить схему и найти неоднозначности;
- сравнить варианты методики;
- получить SQL под конкретный диалект;
- получить формулы Excel или Python-код;
- разобрать ошибку после запуска;
- интерпретировать компактные агрегаты;
- сформулировать гипотезы для маркетинга и продаж.
Нельзя считать, что чат сам обработал всю базу, если вы передали только описание. Он также не подтверждает корректность кода без запуска и не доказывает причину поведения клиентов по одному сегменту.
ABC, RFM или оба метода: что выбрать
| Задача | Метод | Объект | Результат |
|---|---|---|---|
| Понять, какие товары, клиенты или категории дают основную долю показателя | ABC | Товар, клиент, категория, услуга | Класс A, B или C по накопленному вкладу |
| Разделить покупателей по давности, частоте и сумме покупок | RFM | Клиент | Баллы R, F, M и бизнес-сегмент |
| Отделить ценных активных клиентов от ценных, но давно не покупавших | ABC + RFM | Клиент | Вклад клиента плюс состояние отношений |
ABC отвечает на вопрос «кто формирует результат», а RFM — «как клиент покупал в выбранном периоде». Например, два клиента могут попасть в класс A по выручке. Но у одного последняя покупка была вчера, а у другого — девять месяцев назад. RFM покажет эту разницу.
Сочетать методы лучше после отдельных расчётов. Сначала проверьте ABC-класс и три RFM-признака, затем соедините результаты по стабильному идентификатору клиента. Не просите модель сразу придумать двадцать сегментов: начните с тех, для которых есть понятное действие.
Какие данные и правила подготовить до первого запроса
Не начинайте с фразы «сделай RFM-анализ моей базы». Передайте модели контракт данных:
- Бизнес-вопрос: какое решение вы хотите принять.
- Объект анализа: клиент, товар, категория или услуга.
- Тип одной строки: заказ или позиция заказа. Это критично: пять строк одной покупки нельзя считать пятью покупками.
- Схема: поле, смысл, тип данных и пример значения.
- Период: начало, конец и фиксированная дата анализа.
- Фильтры: оплаченные заказы, отмены, тестовые записи, корпоративные клиенты.
- Деньги: выручка или маржа, сумма до или после скидки, валовая или чистая, правило возвратов, валюта.
- Пороговые правила: границы ABC и способ получения баллов RFM.
- SQL-диалект или среда: PostgreSQL, ClickHouse, BigQuery, Excel, Google Таблицы, Python.
- Контрольные итоги: число заказов, число клиентов и сумма показателя после фильтров.
- Образец: 10–30 обезличенных строк, включая возврат, дубль и клиента с одной покупкой.
Для большой таблицы образец нужен не для финального подсчёта, а чтобы чат понял структуру. Дополнительно можно передать профиль данных: количество строк, долю пропусков, минимальную и максимальную дату, число уникальных клиентов и заказов. Идентификаторы замените на client_001, order_001; имена, телефоны и адреса для расчёта не нужны.
Рабочий процесс для таблицы на десятки тысяч строк
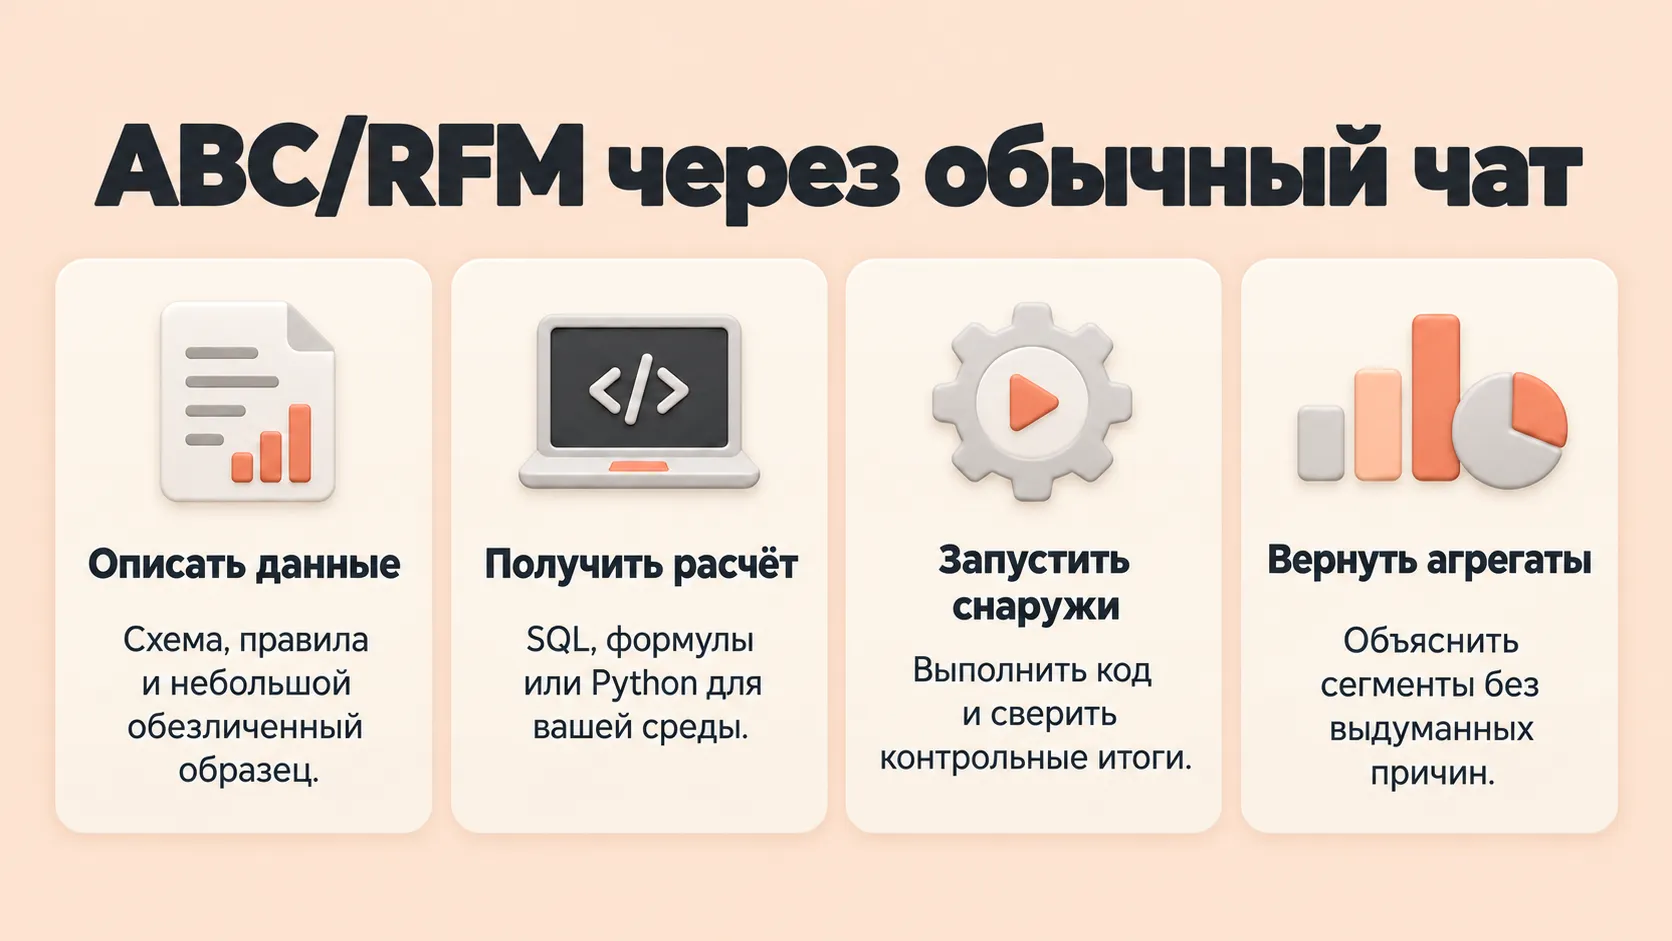
Чат проектирует и объясняет расчёт, а большая таблица обрабатывается в вашей рабочей среде.
- Опишите схему, гранулярность, бизнес-правила и передайте небольшой образец.
- Попросите сначала спецификацию расчёта, затем SQL, формулы или Python.
- Запустите результат вне чата и сравните его с контрольными итогами.
- Верните компактную таблицу: сегмент, число клиентов, выручка, средний чек, медианная давность и изменение к прошлому периоду.
Так контекст не забивается тысячами однотипных строк. В диалоге остаётся то, что действительно требует рассуждения: определения, исключения, ошибки и выводы.
Готовые промпты для ABC- и RFM-анализа
1. Проверить схему до расчёта
Я готовлю ABC- и RFM-анализ. Пока не пиши SQL и не считай результат.

Цель: [решение].
Одна строка: [заказ / позиция заказа].
Схема: [поле / смысл / тип / пример].
Период: [даты].
Фильтры: [статусы и исключения].
Образец: [10–30 обезличенных строк].
Контрольные итоги после фильтров: [строки, заказы, клиенты, сумма].

Проверь, достаточно ли данных. Найди неоднозначности в идентификаторах, датах, суммах, дублях, отменах и возвратах. Верни:
1) критичные вопросы;
2) таблицу «Риск / Почему влияет / Как проверить»;
3) рекомендуемую гранулярность для ABC и RFM.
Не придумывай отсутствующие правила.
Пример фрагмента хорошего ответа:
Критичный вопрос 1: строка означает заказ или товарную позицию?
Влияние: если это позиция, COUNT(*) завысит Frequency. Нужен COUNT(DISTINCT order_id).

Критичный вопрос 2: amount уже уменьшен на возврат?
Влияние: иначе Monetary и вклад в ABC будут завышены.

Проверка: после фильтра status = 'paid' число уникальных order_id должно совпасть с контрольным значением 18 420.
Такой ответ полезнее, чем мгновенно сгенерированный запрос на неизвестную таблицу.
2. Выбрать методику и зафиксировать определения
На основе согласованной схемы подготовь спецификацию ABC- и RFM-анализа без кода.

Для ABC укажи: объект, метрику, сортировку, формулу доли, формулу накопленной доли и границы классов. Пороги 80/95/100 используй только как стартовый вариант и явно пометь их как настраиваемые.

Для RFM укажи: фиксированную analysis_date, формулы Recency, Frequency и Monetary, период наблюдения, фильтры, способ присвоения баллов 1–5 и правило одинаковых значений на границах.

Отдельно перечисли решения, которые должен принять бизнес. Результат верни таблицей «Параметр / Предлагаемое правило / Альтернатива / Риск».
3. Получить SQL для ABC-анализа
Напиши SQL для ABC-анализа в PostgreSQL 18.

Таблица: order_items.
Одна строка: позиция заказа.
Поля: order_id, paid_at, product_id, status, net_revenue, margin.
Период: 2026-01-01 включительно — 2026-07-01 не включительно.
Включать только status = 'paid'.
Объект: product_id.
Метрика: SUM(margin).
Границы: A — накопленная доля до 80% включительно, B — свыше 80% до 95% включительно, C — свыше 95%.

Сначала словами опиши этапы. Затем верни один запрос на CTE, который показывает product_id, metric_value, value_share, cumulative_share и abc_class. Не используй NTILE для ABC. Добавь стабильную сортировку product_id при одинаковой марже, комментарии и три контрольных запроса: итоговая маржа, число товаров и сумма долей. Не утверждай, что запускал SQL.
Почему запрет на NTILE указан прямо? В PostgreSQL эта функция делит строки на приблизительно равные по числу группы. ABC же обычно опирается на накопленную долю показателя. cume_dist тоже описывает положение строк в распределении, а не долю денежного вклада. Различия функций зафиксированы в актуальной документации PostgreSQL.
Ожидаемая форма ответа:
Этап 1. Суммировать margin по product_id.
Этап 2. Рассчитать общую margin и долю каждого товара.
Этап 3. Отсортировать по metric_value DESC, product_id.
Этап 4. Рассчитать SUM(metric_value) OVER (...) / total_value.
Этап 5. Присвоить A/B/C по заданным границам.

Контроль:
- SUM(metric_value) в результате = SUM(margin) исходных строк после фильтра;
- SUM(value_share) близка к 1 с учётом округления;
- каждый product_id встречается один раз.
4. Получить SQL для RFM-анализа
Напиши SQL для RFM-анализа в PostgreSQL 18.

Таблица: orders.
Одна строка: один заказ.
Поля: order_id, customer_id, paid_at, status, net_amount.
Период покупок: 2025-07-01 включительно — 2026-07-01 не включительно.
analysis_date: DATE '2026-07-01'.
Включать status = 'paid'; net_amount уже учитывает возвраты.

Формулы:
- recency_days = analysis_date - MAX(paid_at::date);
- frequency_orders = COUNT(DISTINCT order_id);
- monetary_value = SUM(net_amount).

Присвой каждой метрике балл 1–5 по квинтилям: меньшая recency получает больший балл, большие frequency и monetary — больший балл. Явно обработай одинаковые значения и объясни выбранное правило. Верни один SQL на CTE с полями customer_id, три исходных показателя, r_score, f_score, m_score и код rfm_code. Добавь контрольные запросы и предупреждение для малой выборки. Не придумывай названия бизнес-сегментов без отдельной таблицы правил.
Пример части ответа на условных тестовых данных после запуска запроса пользователем:
| customer_id | recency_days | frequency_orders | monetary_value | rfm_code |
|---|---|---|---|---|
| client_014 | 5 | 12 | 184500 | 555 |
| client_027 | 18 | 3 | 42600 | 433 |
| client_091 | 210 | 9 | 167000 | 155 |
Здесь 155 не означает «плохой клиент». Это описание: покупал давно, но раньше покупал часто и на большую сумму. Действие для такого клиента — гипотеза, а не математический вывод.
5. Получить формулы Excel или Python вместо SQL
Расчёт нужно выполнить в [Excel 365 / Python pandas], а не в SQL. Используй уже согласованные определения ABC и RFM. Сначала перечисли структуру промежуточных таблиц и порядок расчёта. Затем дай [формулы для структурированных ссылок / полный Python-скрипт].

Ограничения: исходник большой, поэтому не предлагай вставлять его в чат. Не меняй названия колонок. Добавь проверки числа уникальных заказов, суммы net_amount и одной вручную выбранной карточки клиента. Я выполню расчёт сам и верну ошибку или агрегаты.
Если вы выбираете Excel, заранее укажите язык интерфейса и разделитель аргументов. Для Python — версию, формат файла, кодировку и ожидаемый путь вывода.
6. Исправить ошибку после запуска
Я выполнил твой SQL в PostgreSQL 18 и получил ошибку:
[полный текст ошибки].

Ниже актуальная схема и полный запрос:
[схема]
[SQL]

Сначала объясни причину простыми словами. Затем верни полный исправленный запрос, а не отдельный фрагмент. Не меняй бизнес-правила, период и фильтры. В конце добавь проверку, которая воспроизводит именно эту проблему на пяти тестовых строках.
7. Интерпретировать агрегаты без выдуманных причин
Ниже обезличенные агрегаты RFM по двум периодам: segment, customers, revenue, avg_check, median_recency_days, repeat_rate и изменение показателей.

[таблица до 30 строк]

Проанализируй только переданные значения. Отделяй наблюдения от гипотез. Для каждого важного сегмента верни:
1) наблюдение с цифрами;
2) возможные объяснения, помеченные как гипотезы;
3) одно действие;
4) метрику проверки;
5) риск неверной интерпретации.

Не называй причин, которых нет в данных, и не обещай рост продаж.
Пример ответа:
Наблюдение: в сегменте «ценные, давно не покупали» 412 клиентов, 14% клиентской базы и 28% выручки предыдущего периода. Медианная давность выросла с 74 до 103 дней.

Гипотеза: часть клиентов могла исчерпать обычный цикл повторной покупки. Данные не показывают, ушли ли они к конкуренту.

Действие: проверить реактивационную коммуникацию на случайной контрольной группе.
Метрика: дополнительная доля повторных покупок за 30 дней относительно контроля.
8. Сравнить стабильность сегментов по периодам
У меня есть две агрегированные таблицы ABC/RFM за соседние периоды и матрица переходов клиентов между сегментами. Проверь, какие переходы самые массовые, где меняется вклад в выручку и какие выводы могут быть артефактом новых порогов. Сначала сравни правила расчёта и состав базы; если они различаются, не переходи к бизнес-выводам. Верни наблюдения, вопросы и план ручной проверки.Обычный промпт и системный промпт: в чём разница
Обычный пользовательский промпт описывает текущую задачу: таблицу, период, поля и желаемый результат. Системный промпт задаёт устойчивые правила работы на весь диалог: сначала спрашивать определения, не придумывать данные, не утверждать, что код запущен, и всегда добавлять проверки.
| Обычный промпт | Системный промпт |
|---|---|
| Меняется от расчёта к расчёту | Сохраняет роль и правила диалога |
| Содержит конкретную схему и период | Содержит порядок работы и ограничения |
| Просит SQL, формулы или разбор | Определяет, как чат должен отвечать |
| Сам по себе подходит для разовой задачи | Полезен для серии итераций в одном чате |
Системный промпт не подключает инструменты и не превращает чат в агента. Если в интерфейсе нет отдельного поля для системной инструкции, отправьте его первым сообщением, а затем — конкретную задачу. Чёткая цель, контекст, формат и примеры соответствуют рекомендациям OpenAI и Anthropic по построению управляемых промптов.
Системный промпт аналитика ABC/RFM
Ты — помощник аналитика по ABC- и RFM-сегментации в обычном чате. У тебя нет прямого доступа к базе, CRM, Excel, файлам пользователя и среде выполнения. Ты не запускаешь SQL, формулы или Python и не утверждаешь, что проверил результат.

Перед расчётом выясняй:
- бизнес-вопрос и объект анализа;
- что означает одна строка;
- схему и SQL-диалект или рабочую среду;
- период и фиксированную дату анализа;
- статусы, отмены, возвраты, валюту и правило суммы;
- уникальные идентификаторы клиента и заказа;
- метрику и границы ABC;
- определения Recency, Frequency и Monetary;
- способ скоринга, веса и правило одинаковых значений;
- контрольные итоги и обезличенный образец.

Для большой таблицы проси не все строки, а схему, профиль, 10–30 обезличенных строк и контрольные суммы. Сначала возвращай спецификацию расчёта. Код пиши только после подтверждения правил и только под указанную среду.

Не подменяй накопленную долю ABC функцией NTILE. Не считай строки позиций заказами. Не придумывай сегменты, причины поведения и финансовые результаты. Отделяй наблюдения от гипотез.

Каждый технический ответ должен содержать:
1) принятые определения;
2) полный код или формулы без пропусков;
3) допущения;
4) контрольные проверки;
5) инструкцию, что пользователь выполняет вне чата и что вернуть для следующего шага.

При интерпретации агрегатов указывай наблюдение, гипотезу, возможное действие, метрику проверки и риск. Если данных недостаточно, задай вопросы вместо выдумывания результата.
Пример первого сообщения после системного промпта
Нужно сегментировать клиентов интернет-магазина, чтобы выбрать группы для повторных коммуникаций. Одна строка таблицы orders — один заказ. PostgreSQL 18. Поля: order_id UUID, customer_id UUID, paid_at timestamptz, status text, net_amount numeric(14,2). Период: 2025-07-01 — 2026-07-01, дата анализа 2026-07-01. Берём только paid; net_amount уже уменьшен на возвраты. Контроль: 18 420 заказов, 6 380 клиентов, сумма 47 260 000 руб. Сначала проверь определения и предложи методику; SQL пока не пиши.Ожидаемый первый ответ не содержит готовых сегментов. Чат должен уточнить хотя бы валюту, часовой пояс, клиентов без покупок в периоде, обработку нулевых сумм, способ скоринга и правило одинаковых значений.
Какую модель выбрать на дату публикации
По практике редакции, русскоязычные аналитические задачи с неоднозначными бизнес-правилами лучше отдавать сильной актуальной модели OpenAI или Anthropic. Это наблюдение из работы, а не универсальный рейтинг всех провайдеров.
На дату публикации официальный каталог OpenAI называет GPT-6 Astra наиболее способной моделью для сложной сквозной работы, включая рассуждение, код, исследования и документы. Anthropic называет Claude Fable 5.1 своей наиболее способной общедоступной моделью для сложной работы с кодом и знаниями. Для более экономичных итераций у Anthropic актуален Claude Sonnet 5.
Название модели не исправит пустой контекст. Даже сильная модель напишет сомнительный запрос, если не знает, что означает строка, как учесть возвраты и какую дату считать точкой анализа.
Что проверить вручную после расчёта
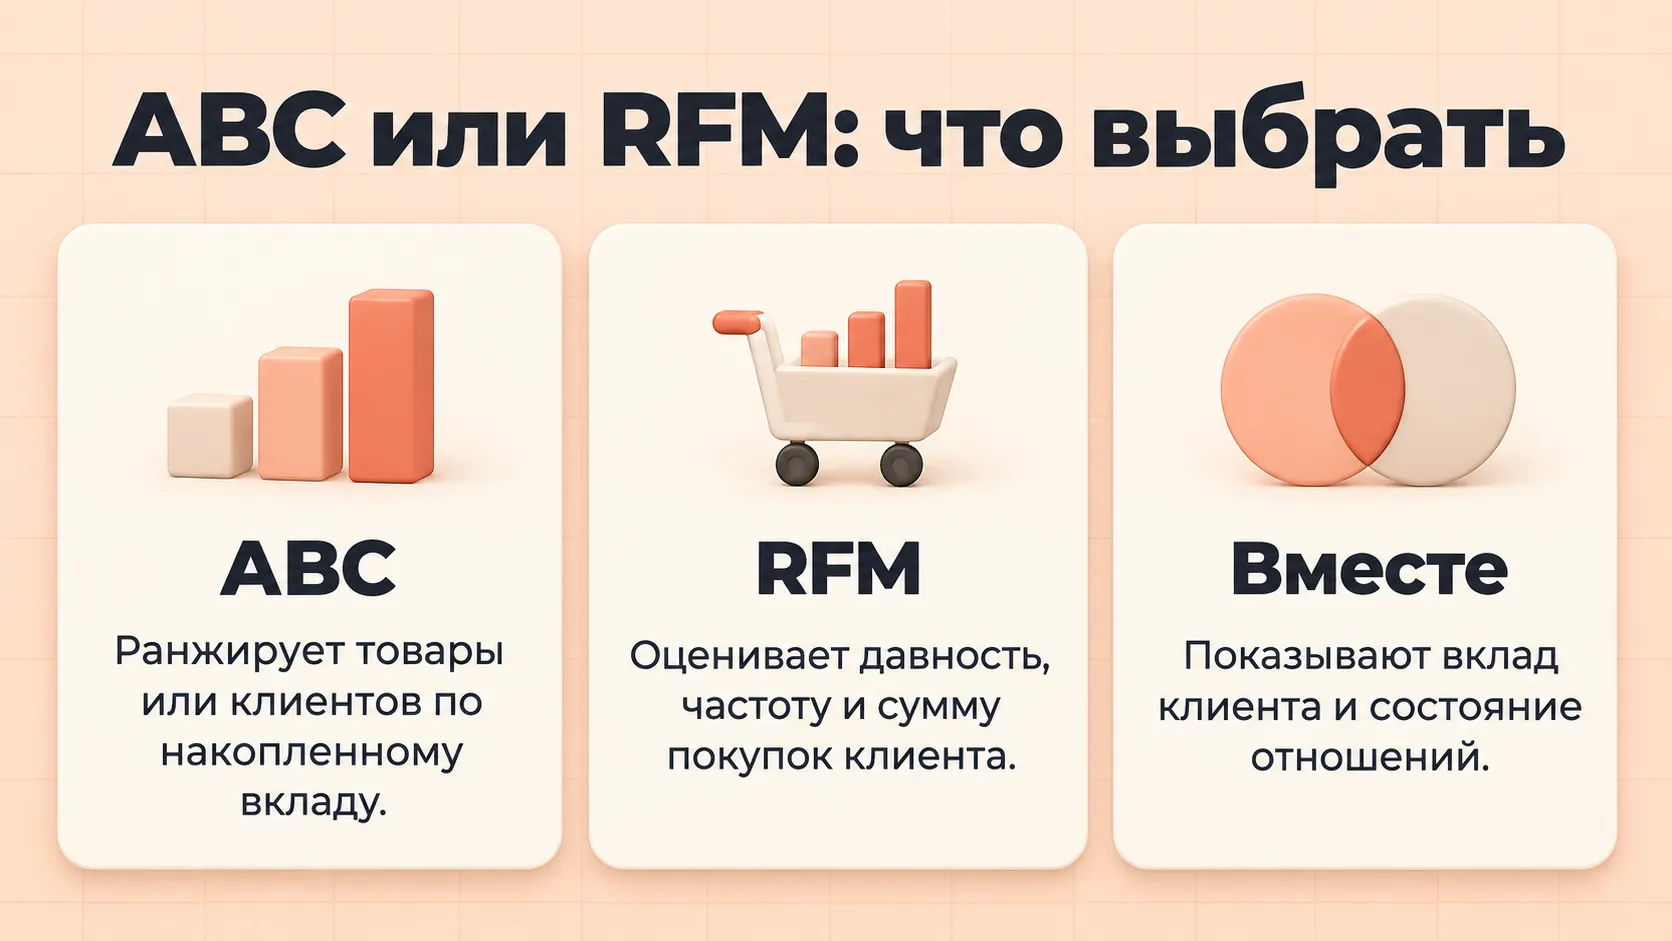
ABC показывает вклад в показатель, RFM — историю покупательского поведения; совместный анализ требует проверить оба расчёта отдельно.
- Гранулярность: один заказ не размножился из-за соединения с позициями.
- Уникальность: каждый объект ABC и каждый клиент RFM встречается в финальной таблице один раз.
- Период: нижняя и верхняя границы трактуются одинаково во всех запросах.
- Recency: вручную пересчитайте три клиента от фиксированной
analysis_date. - Frequency: сравните
COUNT(DISTINCT order_id)с карточками клиентов. - Monetary: сверяйте общую сумму после статусов, отмен и возвратов.
- ABC: сумма долей близка к 100%, накопленная доля не уменьшается, классы соответствуют согласованным границам.
- Ties: одинаковые значения на границе получают объяснимое и воспроизводимое назначение.
- RFM-баллы: меньшая давность даёт больший R-score; большие частота и сумма — большие F- и M-score.
- Размер групп: при малом числе клиентов квинтили могут быть нестабильны или пусты.
- Сравнение периодов: правила, валюта и состав базы не менялись незаметно.
- Бизнес-смысл: название сегмента не выдаётся за доказанную мотивацию клиента.
Отдельно сохраните версию запроса и параметры расчёта. Иначе через месяц невозможно будет понять, сегмент изменился из-за поведения клиентов или из-за новой формулы.
Что Agent Roi сможет сделать — и чего не сможет
В одном диалоге Agent Roi поможет пройти интеллектуальную часть работы: сформулировать методику, подготовить SQL или формулы, разобрать ошибку, проверить логику и превратить компактные агрегаты в проверяемые гипотезы. Контекст предыдущих сообщений удобен: после согласования определений не нужно каждый раз заново объяснять, что считать заказом и как учитывать возвраты.
Но чат не подключается к хранилищу, не запускает запрос, не видит полную базу и не обновляет сегменты по расписанию. Для регулярного процесса понадобятся аналитик, защищённая среда исполнения и контроль качества. Чат остаётся проектировщиком и собеседником, а не скрытым вычислительным сервисом.
Начните с промпта на аудит схемы. После согласования методики получите один запрос, запустите его на копии данных, сверяйте контрольные суммы и только затем обсуждайте маркетинговые действия.
Связанные материалы
- Промпты для очистки таблиц — как описать ошибки, дубли и правила нормализации.
- Промпты для формул Excel — как запросить формулу под конкретную структуру книги.
- ИИ для анализа данных — где проходит граница между чатом и вычислительной средой.
- Как писать промпты для ИИ — базовая структура контекста, ограничений и формата ответа.
Откройте Agent Roi, вставьте системный промпт и начните с описания схемы — без полной клиентской базы и персональных данных. Первый полезный результат здесь не список «чемпионов», а согласованный расчёт, который можно воспроизвести и проверить.
Больше материалов по теме — в разделе «Промпты».