ИИ для анализа данных полезен, когда нужно быстро понять, что происходит в таблице: найти аномалию, сравнить сегменты, подготовить сводку для руководителя или промаркировать отзывы. Но запрос «вот 10 000 строк, сделай выводы» — плохой рабочий процесс. У него есть ограничения по файлам и контексту, а главное — трудно понять, что именно модель посчитала и где она ошиблась.
Ниже — практический разбор: когда достаточно чата или агента, когда считать в SQL или Python, как обработать поток отзывов через n8n и как быстро проверить результат.
ИИ для анализа данных: короткий ответ
- Используйте модель для постановки задачи, написания кода и объяснения, а точные агрегаты считайте в SQL, Python, DuckDB или проверяемой формуле.
- Перед анализом получите профиль данных: строки, столбцы, типы, пропуски, дубли и диапазон дат.
- Храните запрос или код рядом с результатом, чтобы другой сотрудник мог повторить расчёт.
- Отделяйте наблюдение от причины: таблица может подтвердить изменение метрики, но не всегда объясняет, почему оно произошло.
- Для массовой классификации обрабатывайте записи по идентификатору, проверяйте репрезентативную выборку и повторяйте только ошибки.
Что ИИ для анализа данных делает хорошо — и где его нужно ограничить
ИИ хорошо переводит рабочий вопрос на язык анализа. Он помогает сформулировать гипотезу, предложить группировки, объяснить столбцы, написать черновик SQL или Python-кода и превратить расчёт в понятный вывод. Например, руководитель спрашивает: «Почему в июле снизилась повторная покупка?» Агент может предложить разрезы по каналу, региону, первой покупке и сроку доставки, а затем объяснить результат готовой выборки.
Плохо поручать модели «считать глазами». Если в ответе появилась небольшая таблица с итогами, но не видно запроса, кода и исходных строк, это не проверенный расчёт. Модель может перепутать столбцы, посчитать только часть файла, округлить число иначе, придумать причину корреляции или уверенно пересказать несуществующий паттерн.
Полезное разделение ролей выглядит так:
- SQL, Python, DuckDB или BI считают суммы, доли, средние, уникальные значения и фильтры;
- ИИ-агент помогает написать и объяснить вычисление, найти вопросы для следующего шага и описать аномалии;
- человек-владелец метрики подтверждает, что формула и бизнес-смысл верны.
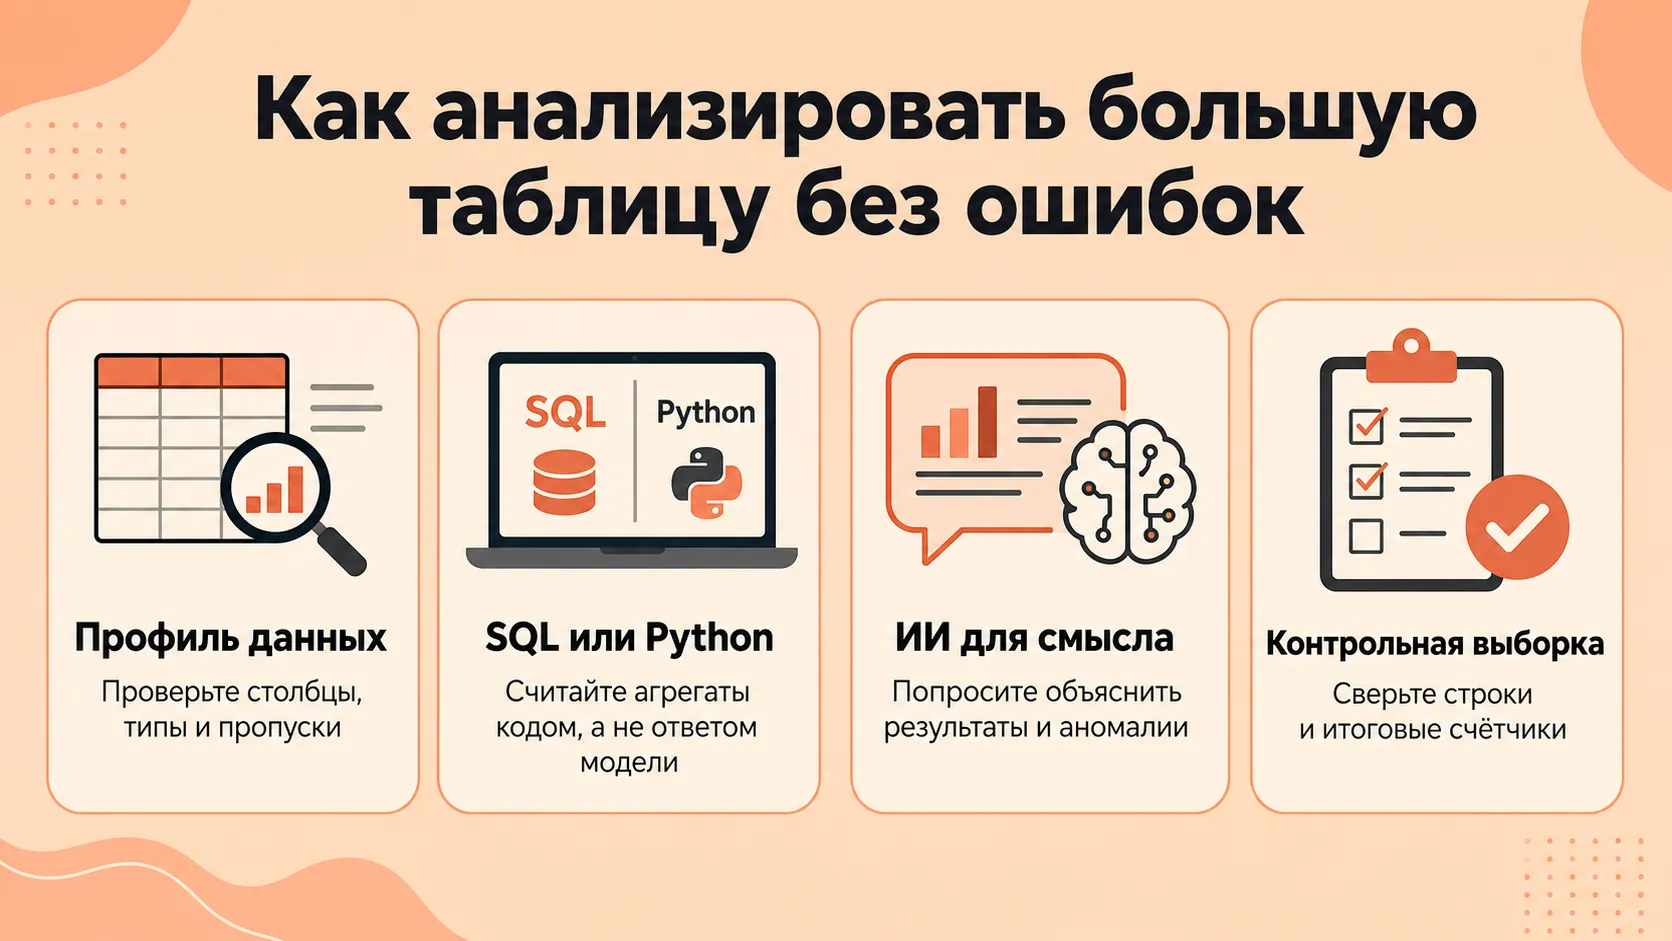
Сначала проверяют структуру и расчёт, затем используют ИИ для интерпретации — не наоборот.
Почему большую таблицу нельзя просто отправить в чат
У любой модели есть ограничение на объём информации, который она получает за один ход. Но «10 000 строк» не является универсальным порогом: короткий CSV из двух колонок и 10 000 длинных отзывов — это совершенно разный объём. Важны ширина таблицы, длина текста, формат файла, лимиты конкретного продукта и то, читает ли агент файл инструментом или пытается положить его целиком в промпт.
Например, ChatGPT поддерживает анализ загруженных таблиц и для части задач запускает Python в рабочем окружении. В справке по загрузке файлов для CSV и таблиц указан ориентир около 50 МБ, а для текстовых документов — ограничение в 2 млн токенов на файл. Это не обещание, что любой файл под лимитом будет полностью и правильно разобран: сложная, плохо структурированная или тяжёлая таблица может обработаться неполностью. Поэтому проверяйте, какие листы, строки и столбцы агент действительно использовал.
Для большой таблицы не просите «прочитать всё и дать ответ». Дайте агенту задачу в три шага:
- Сделать профиль данных: число строк, имена столбцов, типы, долю пустых значений, минимальную и максимальную дату, несколько примеров строк.
- Написать воспроизводимый расчёт: SQL или Python с понятным названием результата. Сначала выполните его, затем попросите агента объяснить именно получившуюся таблицу.
- Проверить крайние случаи: строки с пустым ID, дубликаты, нулевые значения, редкие категории и диапазоны дат.
Так контекст используется для постановки и интерпретации, а не для ненадёжного хранения всей базы в диалоге.
Подготовку файлов, ссылок на фрагменты и безопасный порядок обработки подробнее разбирает статья «ИИ для документов и таблиц».
Какие инструменты актуальны для анализа таблиц
Список меняется быстрее, чем сама логика процесса. На 15 сентября 2026 года для практической работы с таблицами можно рассматривать несколько типов инструментов. Это примеры рабочих контуров, а не рейтинг.
| Инструмент | Где полезен | Ограничение, которое нельзя забывать |
|---|---|---|
| ChatGPT Data Analysis и ChatGPT для Excel/Sheets | Разобрать загруженный файл, построить таблицу или график, выполнить Python-расчёт, работать в контексте книги | Проверяйте код, допущения, формулы и изменённые ячейки перед сохранением |
| Codex | Разобрать папку с данными, написать SQL/Python, запустить проверки и сохранить воспроизводимые артефакты | Нужны явные разрешения, доступ к нужным файлам и независимая сверка вычислений |
| Claude Code | Работать с файлами и командами циклом «контекст → действие → проверка», собрать повторяемую обвязку | Кодовый агент не понимает бизнес-метрику без определения и контрольной выборки |
| Gemini CLI | Запускать автоматизацию в headless-режиме и возвращать структурированный JSON | Нужно проверять входные файлы, права инструментов, формат ответа и код завершения |
| Kimi Agent | Сочетать файлы, браузер, терминал и код в многошаговом сценарии | Нужно отдельно проверить условия обработки данных и разрешённые действия |
| n8n | Запускать один сценарий для многих items, управлять пакетами, лимитами, записью и повторами | n8n организует процесс, но не гарантирует качество меток модели |
Не нужно искать «самого умного агента для всех таблиц». Для разового исследования небольшой чистой книги удобен анализ в чате. Для регулярного отчёта лучше оставить расчёт в SQL или Python. Для тысяч однотипных текстов — например отзывов — полезнее пакетный workflow в n8n.
Если процесс включает несколько инструментов и последующие действия, сначала задайте границы по руководству «ИИ-агенты для бизнеса». Для работы непосредственно в книгах Excel и Google Sheets используйте отдельный разбор «ИИ для Excel и Google Таблиц».
Как применять SQL, Python и DuckDB вместе с агентом
Если таблица большая, агенту не обязательно тащить её в свой контекст. Пусть он работает с базой или локальным движком: формирует запрос, запускает его, получает небольшую итоговую таблицу и объясняет её. В этом и состоит безопасный сценарий «агент + SQL».
Для CSV и локальных файлов удобен DuckDB — встраиваемая аналитическая база с SQL. Она умеет читать CSV, определять разделитель и типы, а также сохранять результат в таблицу. Но автоматическое определение — только старт: у CSV бывают неверный разделитель, даты в разных форматах, смешанные числа и текст. В DuckDB можно зафиксировать схему и параметры явно; это надёжнее, чем не проверять результат автоопределения.
Простой рабочий маршрут:
- Агент пишет профиль и предлагает схему:
order_id, дата, выручка, канал, клиент. - Аналитический инструмент считает контрольные величины: число строк, число уникальных ID, сумму выручки, пропуски и дубликаты.
- Агент предлагает SQL-запрос для сегментации, например по месяцам и каналам.
- Запрос выполняется отдельно. В чат возвращаются сам SQL, итоговая таблица и несколько строк, которые объясняют аномалию.
- Агент пишет вывод с формулировкой «в этой выборке», а не «причина доказана».
Из библиотек чаще всего нужны не экзотические AI-фреймворки, а устойчивый слой работы с данными: pandas или Polars для табличных преобразований, DuckDB или корпоративная БД для SQL, а для модели — строгое JSON-описание результата. MCP-сервер или skill полезен, когда описывает повторяемую процедуру: какие таблицы разрешены, как выглядит запрос, что проверять до записи и куда сохранять лог. Он не отменяет вычислительный движок и не расширяет контекст модели бесконечно.
Когда n8n лучше агента: классификация 20 000 отзывов
Задача «проставить тему, тон и причину обращения у 20 000 отзывов» плохо подходит для одного большого чата: запрос становится тяжёлым, результат трудно продолжить после сбоя, а повторный запуск может задублировать строки. В n8n лучше строить поток, где одна строка становится одним item, а модель получает только текст конкретного отзыва и фиксированную схему ответа.
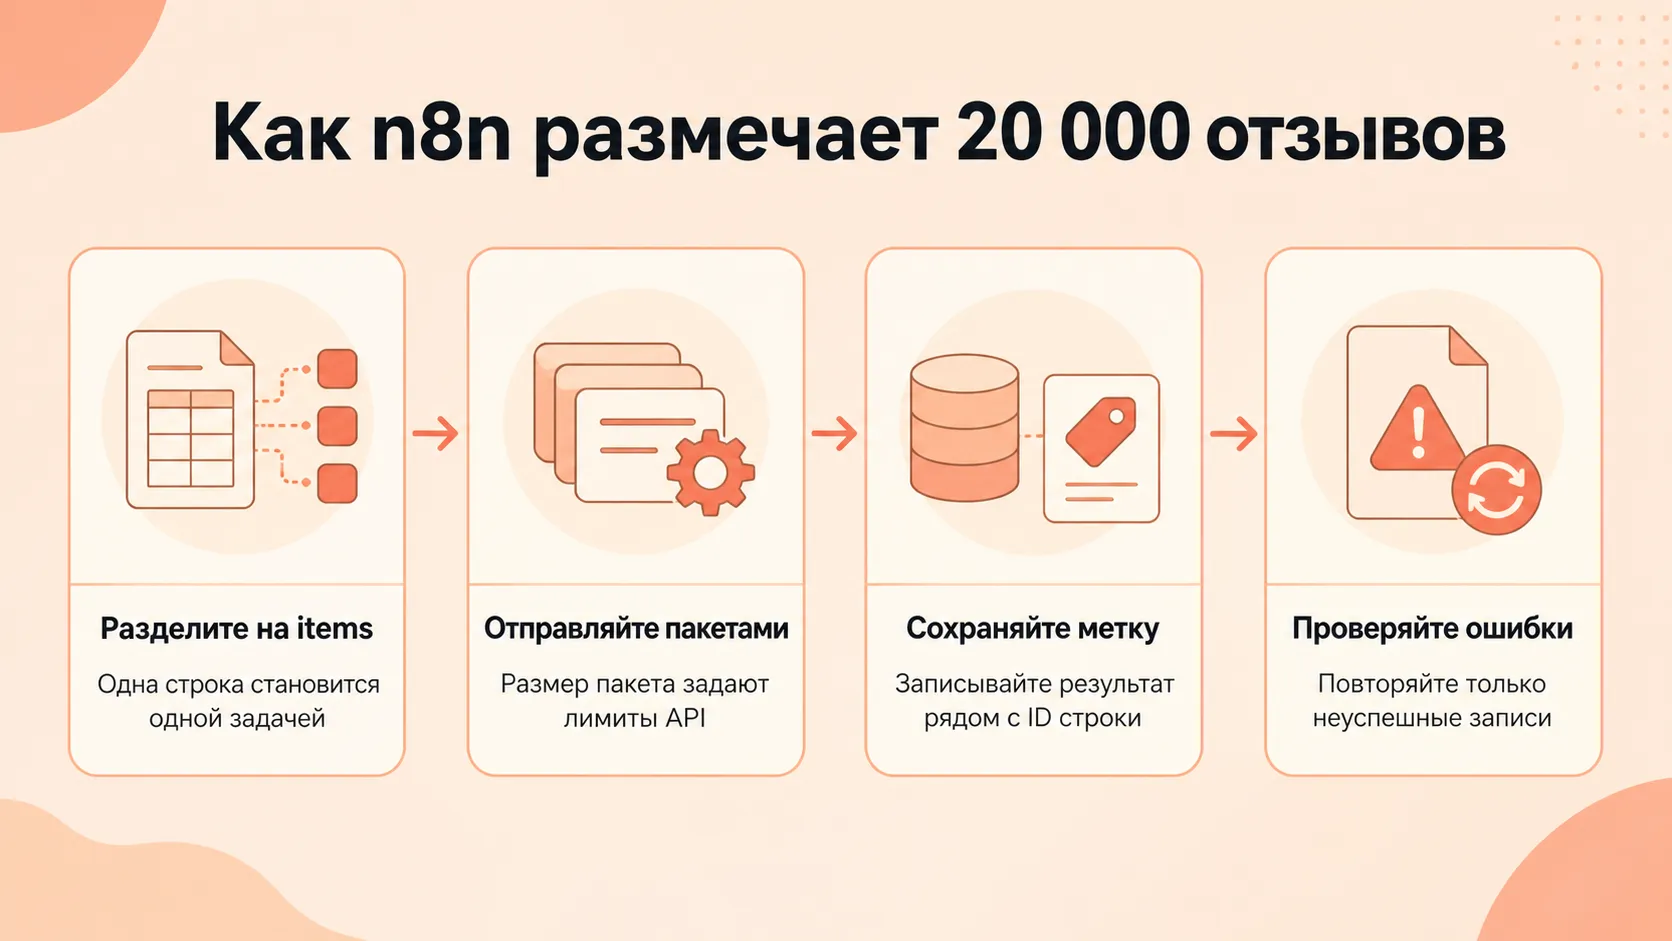
Надёжность такого потока создаёт не модель, а идентификатор строки, запись результата и повтор только неуспешных задач.
Практическая схема для анализа данных в n8n:
- Прочитать CSV, Google Sheets или таблицу БД и сохранить исходный
review_id. - Превратить строки в отдельные items. Многие ноды n8n и так обрабатывают входные items; согласно документации Loop Over Items, отдельный цикл нужен, когда требуется контролировать размер пакета, ограничение частоты или порядок выполнения.
- Отправлять модели один отзыв плюс короткий классификатор. Попросить вернуть JSON, например
{"topic":"доставка","sentiment":"negative","confidence":"low"}. Допустимые значения перечислить в инструкции, а не дать модели придумать свои. - Валидировать JSON и записывать метку рядом с
review_id, моделью, версией промпта и временем обработки. - Ошибки, пустой JSON и неизвестные значения складывать в отдельную очередь. Повторять только их, а не все 20 000 строк.
Размер пакета не выбирают «на глаз». Он зависит от лимитов API, длины отзывов, стоимости и допустимой скорости. Начните с набора, который включает все известные рубрики, короткие и длинные тексты, неоднозначные случаи и пропуски, затем вручную проверьте метки. Увеличивайте объём только после разбора ошибок, добавляя ограничение частоты запросов и обработку сбоев. Важно сделать запись идемпотентной: повтор запуска с тем же review_id не должен создавать вторую запись.
Где ИИ галлюцинирует в итоговой таблице и как быстро это поймать
Самый опасный момент наступает после аккуратного графика: модель пишет правдоподобное объяснение, которого данные не доказывают. «Снижение NPS вызвано новой ценой» может оказаться совпадением с изменением состава клиентов. Сначала отделите вычисленный факт от гипотезы.
| Что проверить | Быстрый контроль |
|---|---|
| Суммы, счётчики и доли | Выполнить независимый SQL/Python-расчёт и сравнить с итоговой таблицей |
| Фильтры и период | Показать в ответе условия: даты, сегменты, исключённые строки и валюту |
| Классификация отзывов | Собрать стратифицированную выборку по рубрикам и уверенности, разметить вручную и посчитать совпадение с моделью |
| Пропуски и дубли | Отдельно вывести число пустых ключей, дубликатов и строк, не прошедших классификацию |
| Объяснение причины | Спросить агента, что именно подтверждает таблица, а что остаётся гипотезой |
Полезный запрос агенту после расчёта: «Покажи SQL или Python-код, список допущений, число исходных и отфильтрованных строк. Затем назови три вывода, которые прямо следуют из результата, и три гипотезы, требующие дополнительной проверки». Такой формат резко снижает риск принять красивый текст за доказательство.
Подводные камни, которые не решает ни одна нейросеть
Большинство сбоев начинается ещё до запроса к модели. В одном файле могут оказаться несколько несвязанных таблиц, заголовки на второй строке, числа в виде текста, даты в разных форматах и одинаковые клиенты с разными ID. Если не зафиксировать эти правила, один и тот же запрос в разные дни даст разные результаты — и агент не заметит проблему сам.
Особенно осторожно работайте с пятью вещами:
- Схема данных. Автоматическое распознавание CSV полезно, но не безошибочно. Проверьте разделитель, кодировку, типы сумм и дат. Если столбец
01-02-2026можно прочитать двумя способами, задайте формат явно. - Определение метрики. «Выручка», «активный клиент» и «негативный отзыв» должны иметь записанное правило. Иначе агент может правильно посчитать не ту метрику.
- Стоимость и лимиты. Построчная классификация 20 000 длинных отзывов — это 20 000 запросов или пакетов, а не один бесплатный ответ. Сначала оцените длину текста, лимит частоты, бюджет и время выполнения.
- Конфиденциальность. Не отправляйте в публичный инструмент персональные данные, договорные цены, номера телефонов или внутренние комментарии без разрешённого контура и минимизации полей. Для маркировки часто достаточно текста отзыва и технического ID.
- Изменение промпта. Если вчера модель ставила три темы, а сегодня вы добавили четвёртую, старые и новые метки нельзя безоговорочно сравнивать. Храните версию инструкции, модели и дату обработки рядом с результатом.
Для важных решений полезен двойной контроль. Первый расчёт строит агент или аналитик, второй — отдельный SQL-запрос либо другой скрипт, который использует те же правила, но не копирует формулу дословно. Несовпадение — не повод попросить модель «исправить красиво», а сигнал вернуться к исходным строкам. Если результат меняет бюджет, цену, приоритет клиента или кадровое решение, на проверку должна попасть не только выборка, но и все заранее определённые пограничные случаи: низкая уверенность, редкая категория и самые крупные значения.
Ещё один частый сбой — смешать анализ и действие в одном шаге. Сначала агент формирует отчёт и список исключений, затем ответственный сотрудник подтверждает правила, и только после этого workflow меняет CRM, отправляет письмо или обновляет статус. Такой порядок оставляет след решения и позволяет остановить процесс до массовой ошибки.
Проверяйте такой переход отдельно.
Для формулировки воспроизводимой задачи используйте структуру из статьи «Как писать промпты для ИИ», но храните определение метрики и контрольные формулы отдельно от свободного текста запроса.
Шаблон запроса для агента
У меня таблица с одной строкой на [объект].

Цель анализа: [какое решение нужно принять].
Столбцы и их смысл: [список].
Период и фильтры: [правила].
Сначала не делай выводов. Подготовь:
1) профиль данных: типы, пропуски, дубли, диапазоны;
2) SQL или Python для расчёта;
3) контрольные числа, которые нужно сверить;
4) итоговую таблицу нужного формата;
5) объяснение, где факт, а где гипотеза.
Не придумывай значения. Покажи код и все допущения.
FAQ
Можно ли загрузить в нейросеть таблицу на 10 000 строк?
Иногда можно, но сначала проверьте лимиты файла и то, как инструмент работает с данными. Количество строк не говорит само за себя: длинные тексты и десятки столбцов быстро увеличивают объём. Для больших файлов надёжнее выполнить расчёт SQL/Python/DuckDB и показать агенту только профиль, запрос и итоговые выборки.
Когда выбирать n8n, а когда SQL?
SQL нужен, когда требуется точный расчёт по большой таблице: группировка, соединение, сумма, доля или фильтр. n8n нужен, когда одну и ту же AI-операцию надо применить к множеству независимых строк: классифицировать отзывы, извлечь сущности, привести текст к рубрикам. Обычно они работают вместе: SQL готовит данные, n8n размечает записи, SQL собирает итоговые показатели.
Может ли агент сам проверить свой результат?
Он может написать вторую проверку, найти несогласованные цифры и отобрать подозрительные строки. Но независимость создаёт не второй красивый ответ, а другой воспроизводимый расчёт и ручная контрольная выборка. Важные метрики должен подтвердить владелец данных.
Вывод
ИИ для аналитики ускоряет путь от вопроса к проверяемому анализу, но не заменяет сам расчёт. Оставьте данные в SQL, Python, DuckDB или корпоративной БД; используйте агента для постановки задачи, кода и объяснения; применяйте n8n для массовой построчной обработки с логом и повтором ошибок.
Начните с одного процесса: соберите тестовый набор, покрывающий известные типы отзывов и граничные случаи, проверьте разметку вручную и только затем масштабируйте workflow. Зафиксируйте входные данные, версию инструкции, код расчёта и критерии приёмки, чтобы следующий прогон можно было сравнить с первым.
Источники
- OpenAI: Data analysis with ChatGPT
- OpenAI: File Uploads FAQ
- OpenAI: ChatGPT for Excel and Google Sheets
- OpenAI: Codex
- Anthropic: How Claude Code works
- n8n: Loop Over Items
- DuckDB: CSV Import
- Gemini CLI: automation
- Kimi Agent overview
Источники и продуктовые возможности проверены 15 сентября 2026 года.
Больше материалов по теме — в разделе «Данные, Excel и аналитика».