Чтобы сравнить ChatGPT, Gemini, Claude и DeepSeek для работы, дайте каждому один и тот же набор заданий и заранее запишите критерии. Для команды важнее узнать, какая модель пропускает обязательные сведения и сколько времени уходит на исправления, чем выбрать самый убедительный ответ. Для первого прохода подойдут три коротких рабочих задания с заранее подготовленными исходниками и эталонами.
Какие задачи взять для сравнения нейросетей
Начните с результата, который команда принимает регулярно. Например, менеджер переносит из клиентского письма номер заказа и просьбу, руководитель совещания собирает поручения, а сотрудник поддержки готовит черновик ответа от лица компании. Для каждой операции выберите типичный случай и один сложный. Если письмо содержит старый и новый номер заказа, модель должна понять, какой действует. Если в протоколе есть обсуждение и решение, они должны попасть в разные списки.
Перенесите структуру и сложность в обезличенный пример. Замените имена, номера и конкретные суммы, сохранив противоречия и пропуски. Если в задаче важна связь между двумя файлами, подмените идентификаторы одинаково в обоих. Для извлечения фактов сделайте эталон с источником каждой строки. Для письма зафиксируйте обязательные сведения, допустимые формулировки и обещания, которые делать нельзя. Эталон нужен до запуска, чтобы красивый ответ не изменил критерии.
| Задание | Что должно получиться | Что считать критической ошибкой |
|---|---|---|
| Разобрать письмо клиента | Просьба, актуальный заказ и следующий шаг | Неверный заказ или пропущенная просьба |
| Свести протокол | Обязательства с ответственными, сроками и цитатами | Придуманный срок или исполнитель |
| Подготовить черновик письма | Ответ по согласованным фактам и срокам | Несогласованная цена, скидка или обещание |
Как выровнять условия и записать результат
Решите, что вы сравниваете. Для сравнения моделей используйте одинаковые тексты и запросы, отдельные чистые ветки, отключённую память и внешние инструменты там, где это возможно. Для сравнения готовых сервисов можно использовать поиск и загрузку файлов, если эти функции нужны вашей команде. Тогда результат относится к режиму сервиса. Если функция недоступна в одном инструменте, отметьте это как ограничение сценария и не заменяйте исходник молча.
Сравнивайте сопоставимые режимы и записывайте дату, продукт, заявленную модель, уровень подписки при необходимости, включённые инструменты и формат входа. Если приложение не показывает точную модель, укажите видимый режим. Запрос оставьте одинаковым на первом проходе. Если захотите оптимизировать его отдельно для каждой модели, сохраните результаты этого подхода вторым тестом. Так будет видно, что дало улучшение: другая модель, другое условие или более точная инструкция.
Для короткой пробы возьмите по одному типовому примеру для каждой из трёх задач. Для четырёх сервисов это 12 первых запусков. Затем добавьте сложные примеры для оставшихся вариантов и повторите решающие или спорные случаи. Два-три повтора могут обнаружить явную нестабильность. В журнале одна строка соответствует одному результату одной модели на одном задании и содержит номер попытки. Для важного процесса расширьте набор и добавьте редкие исключения. Если условия запуска отличаются, это нужно отразить в журнале. Связь оценки с задачей, эталонами и трудными случаями подробно описана в руководстве OpenAI по оценкам.
 Agent ROI
Grok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
Используйте эти модели
в Agent ROI.
Подписку можно оплатить в рублях.
Agent ROIGrok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
Используйте эти модели
в Agent ROI.
Подписку можно оплатить в рублях.
Agent ROI300 ₽ на первые запросы
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Начислим при регистрации в Agent ROI.
 Agent ROI
Grok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
 ChatGPT
 Claude
 Gemini
 Grok
 Perplexity
при регистрации
Agent ROIGrok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
Используйте эти модели
в Agent ROI.
Подписку можно оплатить в рублях.
Agent ROIОплачивайте подписку
в рублях
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Карту для старта
привязывать не нужно.
при регистрации
Agent ROIНа первые запросы
к моделям в Agent ROI
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Карту для старта
привязывать не нужно.
Agent ROIОплачивайте подписку
в рублях
ChatGPTClaudeGeminiGrokPerplexityGrok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Agent ROIПопробуйте Grok, ChatGPT,
Gemini, Claude и Perplexity
Эти модели доступны по одной подписке
в Agent ROI.
Начните с бонуса при регистрации.
Agent ROIGrok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
Используйте эти модели
в Agent ROI.
Подписку можно оплатить в рублях.
Agent ROIОплачивайте подписку
в рублях
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Используйте эти модели в Agent ROI.
Agent ROIGrok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
300 ₽ при регистрации
Карту привязывать не нужно.
Используйте эти модели в Agent ROI.
Agent ROIНа первые запросы
к моделям в Agent ROI
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Бонус начислим при регистрации.
Карту привязывать не нужно.
Agent ROI300 ₽ на первые запросы
Бонус при регистрации
Grok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Используйте эти модели в Agent ROI.
Agent ROIОплачивайте подписку
в рублях
ChatGPTClaudeGeminiGrokPerplexityGrok, ChatGPT, Gemini, Claude
и Perplexity доступны по одной подписке.
Карту привязывать не нужно
Agent ROIGrok, ChatGPT, Gemini, Claude
и Perplexity — по одной подписке
Используйте эти модели
в Agent ROI.
Подписку можно оплатить в рублях.
Agent ROIПопробуйте Grok, ChatGPT,
Gemini, Claude и Perplexity
Эти модели доступны по одной подписке
в Agent ROI.
Бонус начислим при регистрации.
Карту привязывать не нужно.
при регистрации
Как оценить факты, удобство и время правок
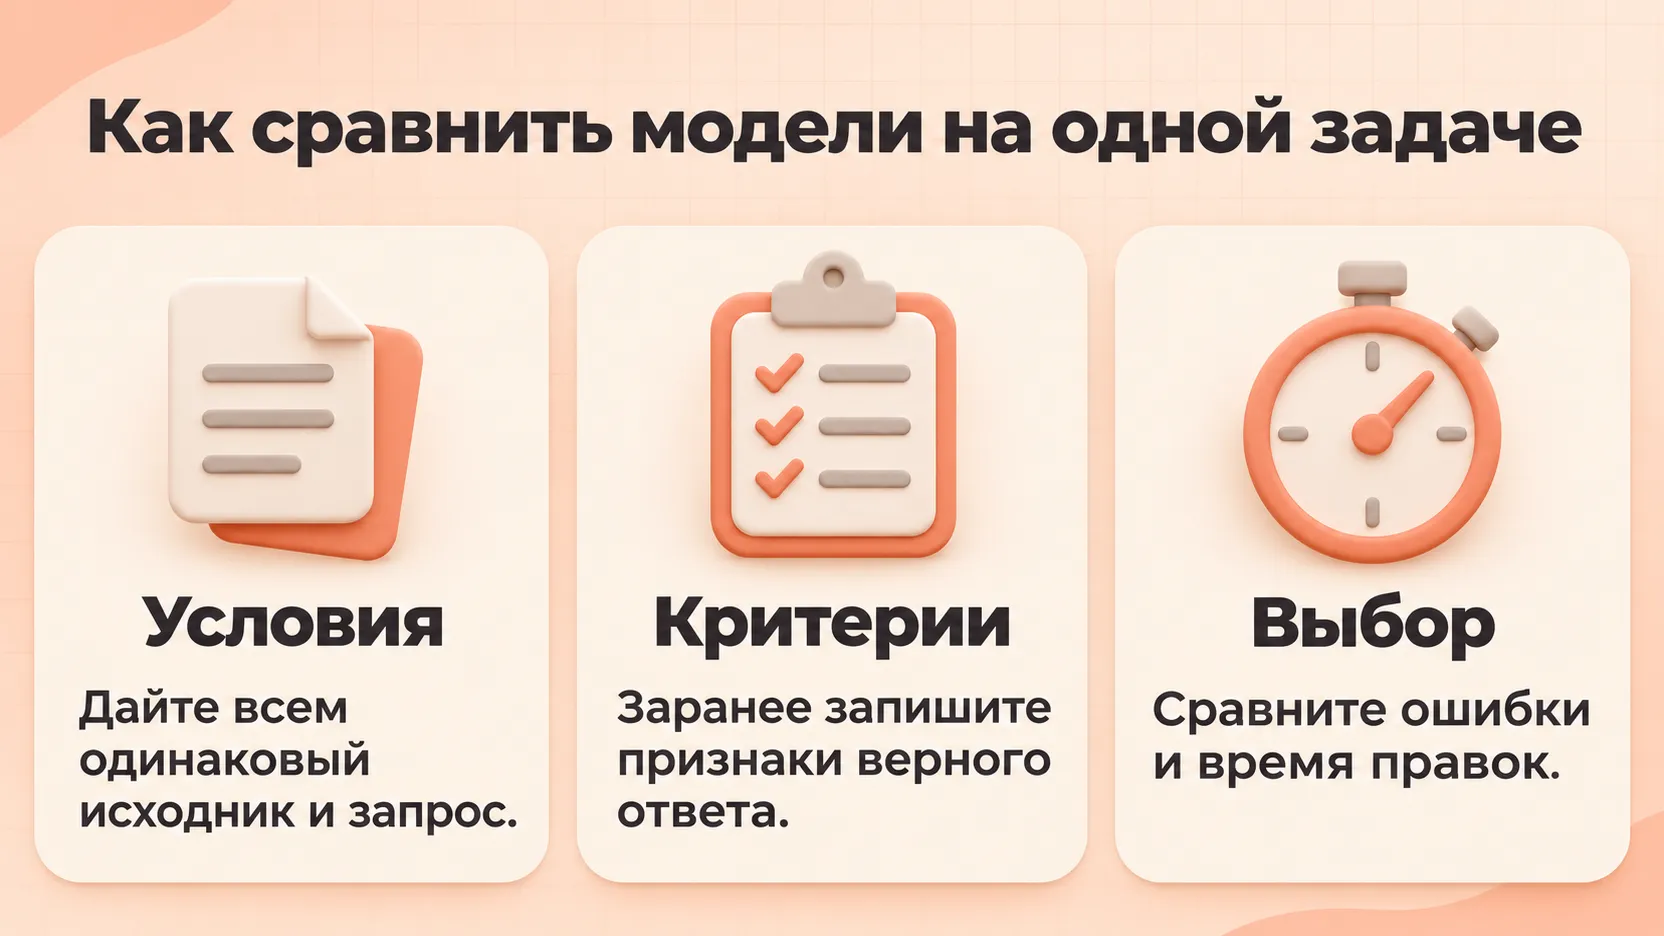
Начинайте с критериев, при которых ответ пригоден. Пусть каждый ответ получит оценки за полноту требований, точность фактов и пригодность формата. Можно использовать простую шкалу: 0 — критерий провален, 1 — нужна правка, 2 — можно принять. Критические ошибки отмечайте отдельно. Например, за правильный тон письма можно поставить 2, но обещание скидки, которой нет в исходнике, делает письмо непригодным к отправке.
Проверяйте факты по исходному письму или строке. Для длинного документа сверяйте пропуски по эталонному списку. Измеряйте время от отправки запроса до готового результата после ручной проверки. Если модель ответила за 20 секунд, а сверка заняла пять минут, в журнал заносятся обе величины. Готовый результат в этом случае стоил 5 минут 20 секунд. Когда возможно, попросите коллег проверить результаты без названий моделей. Форму ответа можно закрепить в шаблоне, чтобы разделить стоимость содержательной правки и форматирования.
В учебном примере два варианта прошли три задания по два раза. У каждого из шести ответов отдельно отмечены исход до принятия и затраченные правки. Ответ пригоден, если в нём нет критической ошибки, а итог можно принять после допустимых правок. Например, выровнять формат таблицы можно, если факты и полнота уже проходят критерии. Несогласованное обещание делает попытку непригодной, даже если его можно удалить.
| Вариант | Пригодные ответы из 6 | Критические ошибки | Медиана времени до готового результата |
|---|---|---|---|
| A | 5 | 1 | 2 минуты 20 секунд |
| B | 6 | 0 | 3 минуты 20 секунд |
Эти числа придуманы для иллюстрации. Если ошибка A состояла в подстановке чужого заказа, отдельная минута правок B может оказаться приемлемой для поддержки. Если другая команда проверяет только тон черновика и сама подставляет реквизиты, её критерии дадут иной результат. Универсальное место в рейтинге не заменяет эту связь.
Как выбрать модель после первого теста
Посмотрите, на каком типе задач устойчиво выигрывает каждый вариант и что влияет на следующий шаг. Если один сервис точнее извлекает данные, а другой лучше готовит проверенные письма, можно распределить задачи. Сделайте это только тогда, когда удобство обучения, хранения данных и оплаты оправдывает второй инструмент. Для команды из нескольких человек один предсказуемый режим может стоить меньше даже при небольшой разнице в результатах.
Для оценки расходов используйте цену подписки или вызовов, затраты на проверку и количество принятых результатов. При регулярной автоматизации понадобится ещё считать повторы, ошибки и стоимость интеграции. Подробности вынесены в гайд по выбору API.
После выбора сохраните входы, версии и критерии. Когда модель или режим обновятся, повторите один типичный и один сложный случай. Если изменится качество, сможете сравнить с исходной таблицей и понять, где меняется ручная проверка. Этот способ измеряет пригодность для вашей задачи в известных условиях.
FAQ
Сколько заданий нужно для сравнения моделей?
Для первого выбора подойдут несколько разных задач и отдельные сложные примеры. Для процесса с существенными последствиями увеличьте набор и проверяйте стабильность на собственных данных.
Обязательно ли выключать поиск?
При сравнении моделей на одинаковом источнике внешний поиск лучше выключить. Если проверяете сервис для поиска, включайте его доступные возможности и записывайте, какой режим использован.
Можно ли выбрать одну модель по итогу теста?
Да, если она проходит обязательные критерии во всех важных сценариях. Если типы задач сильно различаются, посчитайте стоимость поддержки двух режимов и сравните её с выигрышем.
Больше материалов по теме — в разделе «ИИ для бизнеса».