Вы получили договор, отчёт или инструкцию в PDF и хотите быстро найти условие, собрать краткое содержание или задать вопрос по документу. ИИ для PDF помогает с этими задачами, но результат зависит от того, есть ли в файле текст, видит ли выбранная модель изображения страниц и сколько материала реально попало в чат. Ниже — рабочий процесс для обычного чата Agent Roi и обзор актуальных моделей разных провайдеров на 24 сентября 2026 года.
Коротко: текстовый PDF обычно удобнее читать через извлечённый текст; скан требует распознавания или визуального анализа; большой файл может не загрузиться или не поместиться в обработку целиком. В ответах просите страницу и исходный фрагмент. Готовый PDF проверяйте как отдельный документ.
Какой PDF вы загрузили: текстовый, скан или смешанный
Расширение .pdf говорит о формате файла, но не о том, как устроены его страницы. Текстовый PDF содержит цифровой текстовый слой: буквы можно выделить курсором, скопировать и найти поиском. Например, экспортированный из Word договор обычно относится к этому типу. Модель или сервис может извлечь текст напрямую, хотя таблицы, колонки, сноски и порядок чтения всё равно требуют проверки.
Скан PDF — это фотографии или отсканированные изображения страниц, собранные в один файл. На вид это тот же договор, но без текстового слоя поиск по слову ничего не находит. Чтобы получить текст, системе нужен OCR — оптическое распознавание символов — либо модель с доступом к изображению страницы. Размытая печать, наклон, рукописные пометки и мелкие таблицы повышают риск ошибки. Даже если чат уверенно пересказал страницу, номер договора и сумму стоит сверить на оригинальном изображении.
Смешанный PDF содержит и цифровой текст, и сканы: например, основной договор подготовлен в редакторе, а приложение с подписями приложено как изображение. Проверяйте не только первую страницу. Если поиск работает в начале файла и молчит в приложении, для разных частей понадобятся разные способы обработки.
| Тип файла | Быстрая проверка | Что попросить у ИИ | Главный риск |
|---|---|---|---|
| Текстовый PDF | Выделить фразу и найти её поиском | Найти пункт, сравнить условия, сделать саммари с номерами страниц | Потеря порядка колонок, таблиц и сносок |
| Скан PDF | Увеличить страницу и попробовать выделить текст | Распознать страницу или прочитать её визуально, затем извлечь нужные поля | Ошибки OCR в цифрах, именах и мелком шрифте |
| Смешанный PDF | Проверить несколько страниц и приложения | Указать, где текст, а где изображение, и проверить обе части | Незаметный пропуск приложения |
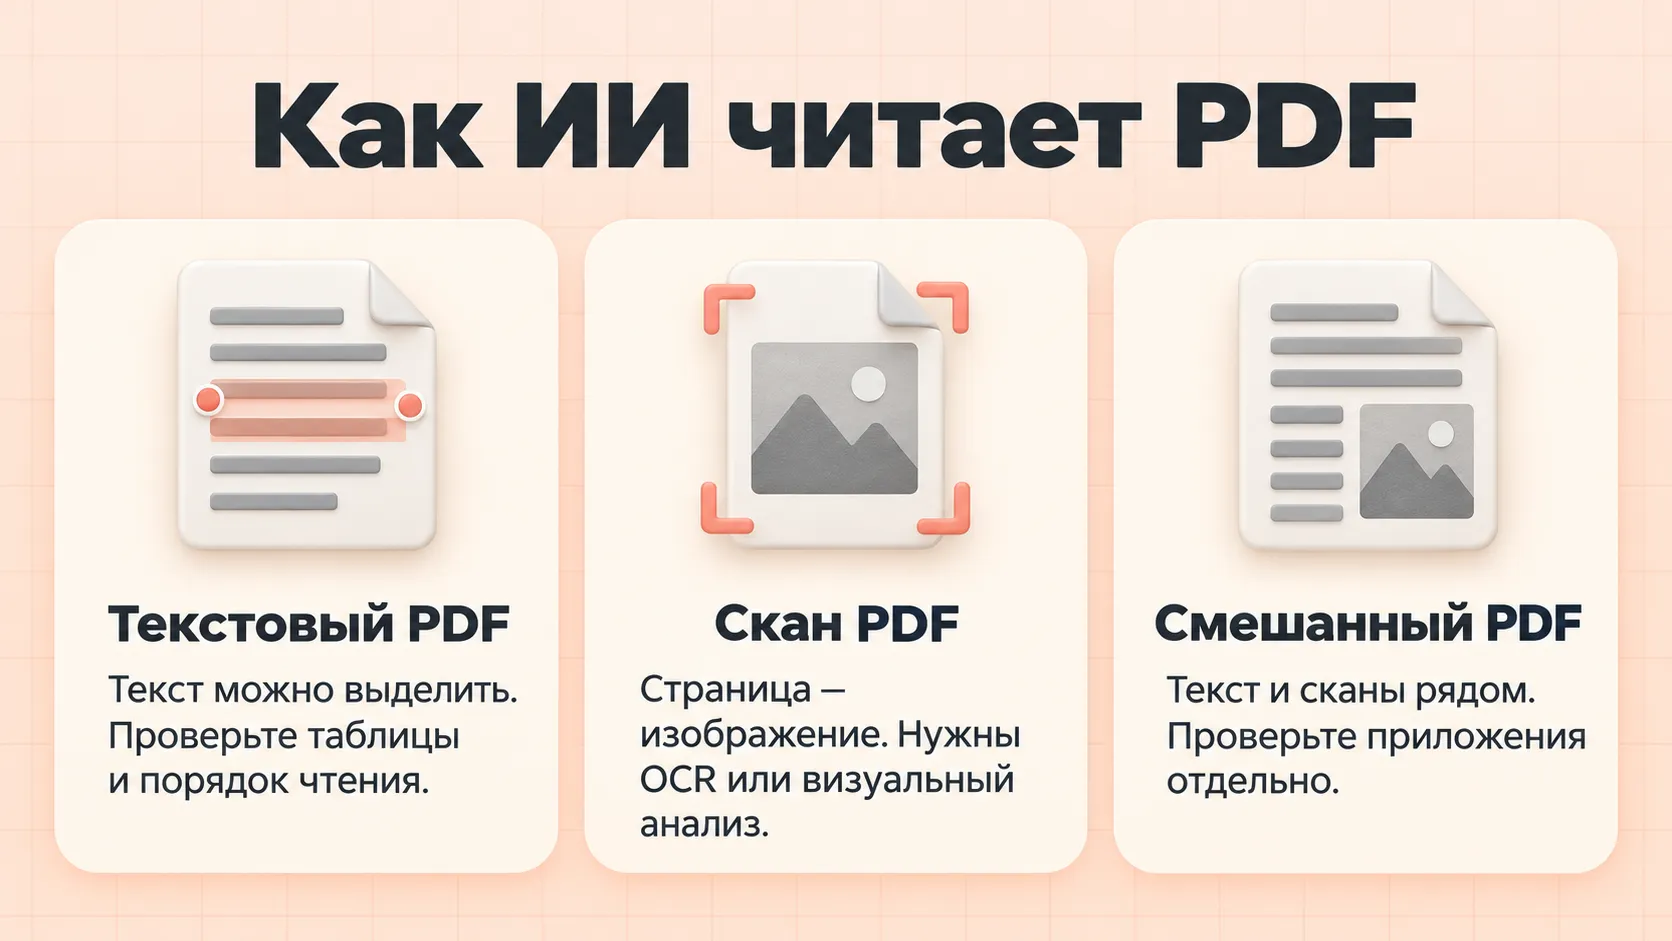
Три типа PDF требуют разной проверки: текстовый слой, распознавание скана и приложения смешанного файла.
Если скан уже имеет качественный OCR-слой, повторное распознавание может быть лишним. Сначала проверьте поиск и копирование, затем сравните пару извлечённых строк с изображением страницы. Это быстрее, чем сразу отправлять весь файл в сложную обработку.
Как ИИ для PDF получает ответ из документа
Работа с PDF состоит из нескольких операций. Сначала чат должен принять файл. Затем сервис извлекает текст, а при поддержке визуального режима передаёт модели изображения страниц. Модель ищет релевантные фрагменты и формулирует ответ. Загрузка файла сама по себе не доказывает, что система прочитала каждую страницу.
Документация OpenAI по файловому вводу описывает передачу в vision-модель и извлечённого текста, и изображений страниц PDF. Anthropic также описывает обработку PDF как сочетание текста и изображения каждой страницы. В Gemini API страницы анализируются визуально, а встроенный текст может передаваться дополнительно. Это описание API провайдеров. Чат на другой платформе может подготавливать файл иначе, ограничивать его размер или включать визуальный режим только для части моделей.
Для договора полезно задать узкий вопрос: «Найди срок оплаты, назови страницу и пункт, приведи короткий фрагмент без пересказа». Откройте указанную страницу и сравните текст. Если ответ содержит несуществующий пункт, не исправляйте его наугад — попросите модель отметить, что нужное условие не найдено. Риск правдоподобного, но ошибочного ответа отдельно описан в профиле генеративного ИИ NIST.
Что умеют актуальные модели OpenAI, Anthropic, Google и DeepSeek
На сентябрь 2026 года у крупных провайдеров есть модели, которые могут работать с изображениями и документами. Однако название модели в селекторе не гарантирует одинаковый способ приёма PDF: важны и модель, и интерфейс сервиса, и включённые инструменты. Поэтому сравнивать стоит проверяемый результат на своём файле, а не только заявленный размер контекста.
| Провайдер и актуальный пример | Подтверждённый путь работы с PDF или изображением | Что проверить в обычном чате |
|---|---|---|
| OpenAI — GPT-6 Astra, Sol или Luna | Актуальная линейка GPT-6 принимает текст и изображения; Responses API описывает обработку PDF с текстом и изображениями страниц для vision-моделей | Принимает ли интерфейс PDF и видит ли выбранный режим схему или скан, а не только текст |
| Anthropic — Claude Sonnet 5 | Релиз Sonnet 5 подтверждает поддержку PDF и vision; документация описывает анализ текста и изображений страниц | Может ли ответ указать нужную страницу и корректно прочитать таблицу или приложение |
| Google — Gemini 3.8 Flash | Релиз от 2 сентября 2026 года и руководство по файловому вводу показывают передачу PDF в Gemini API | Сохраняется ли смысл сложной вёрстки и не пропущены ли страницы при большом файле |
| DeepSeek — V4.1 Flash и отдельный DeepSeek-OCR-2 | V4.1 Flash получил визуальный ввод; DeepSeek-OCR-2 разработан специально для распознавания изображений документов | Доступен ли визуальный ввод в конкретном чате и применяется ли OCR к вашему файлу |
Здесь важно различать две новости DeepSeek. В январе 2026 года команда опубликовала DeepSeek-OCR-2 — отдельную модель для распознавания страниц и сложной компоновки документа. В сентябре компания представила DeepSeek-V4.1-Flash с нативным визуальным вводом через API. Из этого нельзя заключать, что OCR-2 автоматически встроен во все чаты с DeepSeek или что загрузка PDF всегда идёт через него. Для скана проверьте на тестовой странице три поля: имя, дату и сумму. Если OCR ошибается, нужен более качественный скан или другой путь обработки.
Доступность перечисленных версий в Agent Roi и способ передачи файла нужно смотреть в интерфейсе на момент работы. Провайдер может обновить API, но сторонняя платформа не обязана одновременно включить новую модель, визуальный режим и загрузку PDF. В этой статье названия служат ориентиром для выбора и проверки, а не обещанием конкретного пункта в селекторе Agent Roi.
Почему большой PDF не помещается в обычный чат
У большого PDF есть как минимум три границы. Первая — загрузка: интерфейс, тариф или API может ограничивать размер файла и число страниц. Вторая — контекст: модель обрабатывает конечный объём текста и изображений за один запрос. Третья — полнота поиска: даже после успешной загрузки чат может извлечь только часть документа или найти лишь фрагменты, относящиеся к вопросу. Эти границы не равны друг другу.
Например, OpenAI указывает отдельный лимит файлов для запроса Responses API, Google задаёт ограничения PDF по размеру и страницам, а Anthropic предупреждает, что плотный документ может заполнить контекст раньше формального предела страниц. Числа из этих API нельзя переносить на обычный чат Agent Roi: его действующий лимит следует проверить в загрузчике и условиях выбранной модели.
Даже «миллион токенов контекста» не означает, что можно без проверки загрузить огромную папку отчётов. Скан превращает страницы в изображения; таблицы и схемы увеличивают объём обработки. Длинный файл может быть принят, но ключевое приложение окажется вне реально просмотренного фрагмента. Поэтому задавайте вопрос не «прочитай всё», а «проверь раздел о штрафах на страницах 32–48».
Если файл не загружается, не сжимайте его до нечитаемого качества. Уберите пустые страницы, экспортируйте нужную главу или разделите документ по логическим частям. Сохраните названия и диапазоны страниц: договор_основной_1-35.pdf, договор_приложения_36-58.pdf. Для регулярной работы с сотнями документов понадобится отдельный поиск по архиву или другой документный процесс; одно окно чата не заменяет проверяемый индекс.
Как работать с PDF в обычном чате Agent Roi
Начните с одного документа и одного проверяемого вопроса. Не передавайте чувствительный файл без проверки прав доступа и правил вашей организации. В Agent Roi пользователь взаимодействует с чат-ботом на платформе, а не напрямую с API выбранного провайдера: реальные возможности определяются тем, как платформа принимает файл и передаёт его модели.
- Определите тип PDF. Проверьте поиск и выделение текста на нескольких страницах, особенно в приложениях.
- Проверьте, что загрузка прошла. Если файл отклонён или ответ не видит нужный раздел, уменьшите задачу до главы или диапазона страниц.
- Задайте конкретный вопрос. Укажите объект поиска, формат ответа и просьбу отметить отсутствующие данные.
- Попросите опору на документ. Для каждого важного вывода — номер страницы и короткий фрагмент, который вы сможете открыть и проверить.
- Сверьте поля с оригиналом. В первую очередь даты, суммы, реквизиты, отрицания, сноски и данные из таблиц.
Пример запроса для текстового договора:
Найди в приложенном PDF условия оплаты и расторжения. Для каждого условия укажи страницу, номер пункта и короткий фрагмент исходного текста. Если условие не найдено, так и напиши. Не делай юридический вывод; отдельно перечисли места, которые нужно проверить вручную.
Для скана добавьте: «Сначала скажи, видишь ли ты текст на изображениях страниц. Если нет — не угадывай содержание. После распознавания покажи сомнительные символы в суммах и датах». Это проверяет саму возможность работы со сканом прежде, чем вы доверите чату вывод. На плохой копии полезнее распознать несколько нужных страниц, чем просить глобальное саммари.
Как получить PDF на выходе
Чтение PDF и создание PDF — разные операции. Языковая модель может написать содержание и предложить структуру. Чтобы получить настоящий файл с фиксированной вёрсткой, сервису нужен инструмент сборки документа. По релизу Agent Roi v2.1 платформа умеет генерировать DOC/PDF прямо из чата: готовый файл приходит отдельной карточкой. Доступность действия и качество вёрстки проверяйте в текущем интерфейсе.
Рабочая последовательность: попросите составить структуру отчёта, согласуйте факты и таблицы, затем явно запросите «создай PDF-файл», а не только «покажи текст». После получения файла откройте его и проверьте страницы: не обрезаны ли таблицы, нет ли пустых листов, корректны ли шрифты, ссылки, реквизиты и номера. Если нужен дальнейший совместный редакторский цикл, сначала получите редактируемый формат и экспортируйте утверждённую версию в PDF.
FAQ
Может ли ИИ читать PDF, если в нём только сканы?
Может, если конкретный чат передаёт изображения страниц модели с визуальным пониманием или выполняет OCR. Само наличие функции загрузки PDF этого не доказывает. Проверьте на одной странице с известными датой и суммой.
Как сделать суммаризацию PDF без потери важных деталей?
Назовите цель саммари и разделы, которые нельзя пропустить. Попросите для каждого тезиса страницу и пометку «не найдено», если данных нет. Затем вручную сравните ключевые решения и цифры с оригиналом.
Почему чат принял файл, но не отвечает по последним страницам?
Файл мог пройти загрузку, но превысить объём фактической обработки или поиск не нашёл нужный фрагмент. Задайте вопрос по конкретному диапазону страниц либо передайте отдельную главу. Не считайте согласный ответ доказательством полного чтения.
DeepSeek-OCR-2 уже работает в каждом чате DeepSeek?
Нет оснований так утверждать. DeepSeek-OCR-2 — отдельный опубликованный OCR-проект; DeepSeek-V4.1-Flash — другая модель с визуальным вводом. Проверяйте настройки и результат в том продукте, где работаете.
Можно ли сразу отправлять клиенту PDF, созданный ИИ?
Сначала откройте готовый файл и проверьте факты, числа, вёрстку и ссылки. Особенно внимательно — договоры, финансовые и кадровые документы. Генерация файла не означает утверждение его содержания.
С чего начать
Возьмите типичный рабочий PDF на 5–10 страниц, проверьте текстовый слой и задайте в Agent Roi один вопрос с требованием страницы и фрагмента. Сверьте ответ с оригиналом. Если такой тест проходит, переходите к большему документу по разделам и только затем к созданию PDF-отчёта по проверенным данным.
Больше материалов по теме — в разделе «Документы и тексты».