Собрать рабочий прототип сервиса за вечер с помощью ИИ уже реально. Намного сложнее понять, можно ли этот код поддерживать, безопасно развернуть и передать команде. В этой статье разберём, что умеет ИИ для кода в 2026 году, чем чат отличается от coding-агента, какие инструменты актуальны и где заканчивается быстрая демонстрация и начинается настоящая разработка.
ИИ для кода в 2026 году: четыре разных режима работы
Фразы «ИИ пишет код» и «ИИ-агент разрабатывает приложение» часто описывают совсем разные процессы. В одном случае модель возвращает фрагмент Python в чате. В другом — агент самостоятельно ищет нужные файлы, меняет репозиторий, запускает тесты и показывает diff. Поэтому сравнивать такие инструменты только по названию модели бесполезно.
| Режим | Что получает ИИ | Что он может сделать | Где полезен | Главная граница |
|---|---|---|---|---|
| Обычный чат | Текст вопроса и вставленные пользователем фрагменты | Объяснить код, предложить алгоритм, написать небольшой модуль или SQL | Обучение, проектирование, локальные примеры | Не видит репозиторий и не проверяет результат сам |
| Автодополнение и IDE-помощник | Открытый файл, соседний код, иногда индекс проекта | Дописывать строки, функции и небольшие изменения | Быстрый набор типового кода | Обычно действует в узком локальном контексте |
| Локальный coding-агент | Репозиторий, терминал, правила проекта, разрешённые инструменты | Искать по коду, менять файлы, запускать команды и тесты | Баги, функции, рефакторинг, исследование кода | Получает доступ к рабочей машине и требует контроля разрешений |
| Облачный асинхронный агент | Клон репозитория и подготовленное окружение в VM | Работать в фоне, создавать ветку или pull request, запускать проверки | Параллельные задачи и хорошо описанный backlog | Код и окружение обрабатываются в облаке; растут требования к доступам и проверке |
Чат помогает думать, но не замыкает цикл
В чате можно попросить объяснить ошибку, спроектировать API, написать регулярное выражение или проверить вставленный diff. Но чат не знает, какие версии библиотек установлены в проекте, где лежит бизнес-правило и проходит ли предложенный код тесты. Даже правильный на вид ответ остаётся гипотезой до запуска в настоящем окружении.
Это полезный режим, когда нельзя передавать весь репозиторий или задача ещё не готова к реализации. Например, архитектор может обсудить варианты хранения идемпотентности, а затем передать согласованное решение разработчику или агенту с доступом к коду.
IDE-помощник сокращает набор, но не принимает задачу целиком
Автодополнение хорошо угадывает повторяющиеся конструкции: DTO, тестовые фикстуры, преобразование полей, обработчики событий. Оно экономит секунды и минуты много раз за день, но редко владеет полным контекстом изменения. Если рядом существует похожая функция, помощник может воспроизвести и её устаревший паттерн.
Такой режим безопаснее автономного агента, потому что разработчик принимает предложения небольшими частями. Обратная сторона — человек сам ищет файлы, планирует изменение и запускает проверки.
Coding-агент выполняет цикл, а не одну генерацию
Локальные инструменты вроде Claude Code и Codex, агентный режим Cursor, а также модель-агностичные Cline, Roo Code, OpenCode и Aider работают с репозиторием и терминалом. Они могут найти место ошибки, прочитать конфигурацию, отредактировать несколько файлов, запустить тест и продолжить после неудачи.
Это уже не «более длинный чат». Исследование Microsoft по производственным трассам GitHub Copilot показало характерную структуру таких сессий: один запрос пользователя разворачивается в последовательность модельных вызовов, почти каждому из которых соответствует действие инструмента. Практическая ценность появляется именно в этом цикле «прочитать → изменить → выполнить → увидеть ошибку → исправить».
Облачный агент удобен для делегирования, но требует другой модели доверия
Jules, облачные агенты Cursor, Codex Cloud, Devin и агентные сценарии GitHub работают в изолированных удалённых окружениях. Разработчик ставит задачу, агент клонирует репозиторий, готовит ветку, запускает команды и возвращает изменения для ревью.
Это позволяет параллельно отправить несколько независимых задач и не занимать локальный компьютер. Но команде приходится решить, какие репозитории разрешено копировать в облако, какие секреты доступны среде, куда агент может выходить по сети и кто отвечает за итоговый pull request. Автономность экономит внимание только тогда, когда окружение и правила приёмки уже подготовлены.
Если вы сначала выбираете процесс для автоматизации, а не конкретный инструмент для кода, используйте общий чек-лист запуска ИИ-агентов в бизнесе.
Почему результат определяет не только модель
Модель — важная часть coding-агента, но не весь продукт. Результат складывается как минимум из семи слоёв:
- Базовая модель. Насколько хорошо она рассуждает о коде, следует инструкциям и использует инструменты.
- Системные инструкции. Как оболочка учит модель искать файлы, вносить изменения и останавливаться.
- Сбор контекста. Индекс репозитория, поиск по символам, карта зависимостей, правила вроде
AGENTS.mdилиCLAUDE.md. - Инструменты. Чтение и изменение файлов, shell, браузер, Git, MCP-серверы, работа с issue tracker.
- Окружение. Установленные зависимости, базы, сервисы, переменные среды и возможность запустить приложение.
- Разрешения. Что агент может читать, менять, удалять, отправлять по сети и выполнять без подтверждения.
- Контур проверки. Тесты, линтеры, статический анализ, security scan, diff и человеческое ревью.
Поэтому одна и та же модель может вести себя по-разному в Claude Code, Cursor, GitHub Copilot или открытой оболочке. У продуктов различаются системные подсказки, способы редактирования, поиск по коду, управление контекстом и политика повторных попыток.
Обратное тоже верно: дорогая frontier-модель не компенсирует неработающее окружение. В опубликованном в 2026 году GitTaskBench более половины отказов агентов были связаны не с «незнанием программирования», а с настройкой окружения и зависимостей. Исследование использовало модели предыдущего поколения, поэтому его процент успеха нельзя переносить на современные модели. Но тип сбоя никуда не исчез: если проект нельзя воспроизводимо собрать, агенту нечем проверить свой код.
Практический вывод: сначала сравнивайте способность инструмента замкнуть ваш цикл проверки, а уже потом выбирайте модель по benchmark.
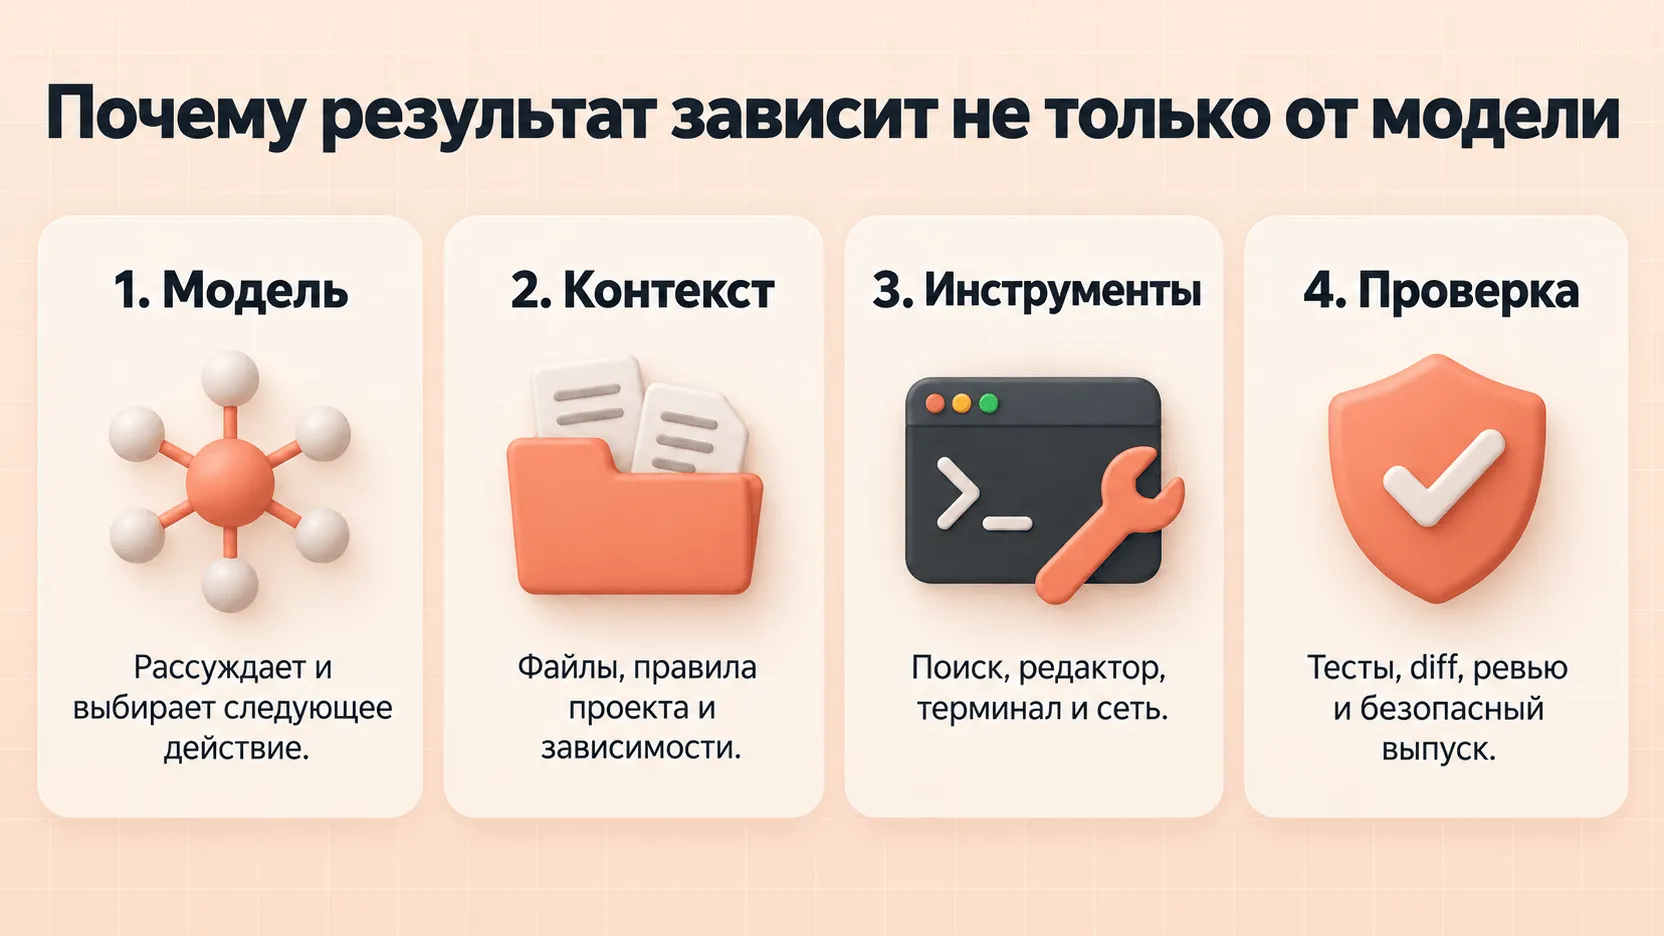
Сильная модель без контекста, инструментов и проверяемого окружения остаётся генератором гипотез.
Какие модели и coding-агенты актуальны на сентябрь 2026 года
Этот раздел — снимок на 18 сентября 2026 года, а не вечный рейтинг. Модели, тарифы и доступность меняются быстрее, чем большинство компаний обновляет внутренние регламенты.
| Класс | Актуальные примеры | Сильная сторона | Что проверить |
|---|---|---|---|
| Вертикальный терминальный агент | Claude Code с Claude Fable 5.1, Opus 5 или Sonnet 5; Codex с GPT-5.3-Codex | Модель и оболочка оптимизируются вместе | Разрешения, лимиты, хранение данных, поддержка вашей ОС и стека |
| Агентная IDE | Cursor Agent и собственная модель Composer 2.5; GitHub Copilot в IDE | Код, diff и управление задачей находятся рядом | Индексация проекта, модель для каждого режима, командные политики |
| Облачный агент | Cursor Cloud Agents, Codex Cloud, Jules, Devin, GitHub Copilot cloud agent | Фоновая работа, отдельная VM, ветка или PR | Облачное хранение, секреты, сеть, стоимость долгих запусков |
| Модель-агностичная оболочка | Cline, Roo Code, OpenCode, Aider | Выбор провайдера, API или локальной модели | Совместимость tool use, стоимость токенов, настройка формата правок |
| Общий персональный агент | Hermes Agent | Навыки, память, MCP, расписания, делегирование и разные провайдеры | Это не специализированный coding harness; нужно отдельно настроить безопасный контур разработки |
Claude Code: сильная связка модели и терминального контура
На дату статьи в семействе Anthropic актуальны Claude Fable 5.1, Claude Opus 5 и Claude Sonnet 5. Fable 5.1 позиционируется Anthropic как наиболее способная модель для сложного программирования и длительных задач, Opus 5 предлагает близкий уровень для повседневного использования, а Sonnet 5 — более экономичный агентный класс.
Сами названия не объясняют весь результат Claude Code. Инструмент читает проектные правила, работает с shell, умеет планировать и вызывать подагентов. В рекомендациях по работе с Claude Code Anthropic советует хранить команды сборки, стиль и ограничения проекта в CLAUDE.md, сначала исследовать код, затем согласовать план и только после этого вносить изменения.
Важно проверять доступность конкретной модели, тариф и условия обработки данных непосредственно перед подключением. Например, некоторые frontier-модели могут иметь отдельные требования к хранению запросов или корпоративным настройкам.
Codex: специализированная модель плюс управляемое выполнение
В официальной документации OpenAI текущей оптимизированной для Codex моделью указана GPT-5.3-Codex. Она предназначена для агентного программирования и поддерживает разные уровни reasoning effort. При этом в других продуктах и партнёрских оболочках доступны общие модели GPT более новых семейств. Нельзя автоматически считать, что любая модель с большим номером лучше именно внутри coding harness.
Сильная сторона Codex — не только генерация, а работа внутри ограниченного workspace, выполнение команд, применение патчей, анализ изображений и итерация по результатам тестов. Локальный режим использует sandbox и политики подтверждения. Это полезнее, чем безусловный «полный доступ»: для исследовательской задачи агенту часто достаточно чтения, а запись и сеть можно разрешить позже.
Cursor и GitHub Copilot: оболочка может выбирать из нескольких моделей
Cursor отделяет Agent от модели: агент предоставляет поиск, редактор, терминал, браузер и правила, а пользователь выбирает движок. Помимо моделей Anthropic, OpenAI и других провайдеров, у Cursor есть собственная агентная модель Composer 2.5, обученная для длительной работы и использования инструментов внутри Cursor.
GitHub Copilot также превратился из автодополнения в платформу: IDE и CLI, облачный coding agent, code review, custom agents и выбор моделей разных провайдеров. Поэтому вопрос «на какой модели работает Copilot?» не имеет одного ответа. Модель зависит от режима, плана, политики организации и конкретной функции; специализированный code review может использовать собственную настроенную смесь.
Jules и другие облачные исполнители
Jules от Google клонирует GitHub-репозиторий в виртуальную машину, предлагает план, меняет отдельную ветку и запускает проверки. Публичная страница продукта на дату исследования связывает Jules с Gemini 3 Pro. Для пользователя важнее не только название Gemini, а то, подготовлен ли setup script и способен ли агент воспроизвести проект в своей VM.
Devin, Cursor Cloud Agents, Codex Cloud и Copilot cloud agent решают похожую организационную задачу: превращают issue или промпт в проверяемую ветку. Они удобны для backlog, но слабое техническое задание не становится хорошим только из-за удалённого выполнения.
Hermes и открытые оболочки: гибкость вместо готового вертикального продукта
Hermes Agent от Nous Research — общий провайдер-независимый агент, а не IDE-помощник. Он поддерживает разные модели и провайдеры, память, навыки, MCP, подагентов и работу через каналы. Его можно настроить для разработки или поручить ему запуск специализированного coding-агента. Но это уже инженерия собственного контура: владелец отвечает за модель, инструменты, секреты, изоляцию и обновления.
Cline, Roo Code, OpenCode и Aider дают похожую свободу на уровне coding-оболочки. Можно подключить Claude, GPT, Gemini, OpenRouter или локальную модель. Это снижает зависимость от одного поставщика, но добавляет настройку. Не каждая сильная чат-модель одинаково хорошо соблюдает формат патча, вызывает инструменты и удерживает длинный цикл исправлений.
Как выбирать без бесконечного сравнения benchmark
Сведите выбор к пяти вопросам:
- Агент работает локально или в облаке?
- Может ли он воспроизвести окружение и запустить обязательные проверки?
- Какие файлы, команды, сеть и секреты ему доступны?
- Можно ли увидеть план, журнал действий и компактный diff до слияния?
- Какая модель даёт приемлемое сочетание качества, задержки и стоимости именно на ваших задачах?
Проведите один и тот же набор из 10–20 задач через два-три кандидата. Сравнивайте не красоту объяснений, а долю принятых изменений, время человеческой проверки, количество повторных итераций и дефекты после слияния.
Где ИИ для программирования уже даёт реальное ускорение
Coding-агенты особенно сильны там, где задача ограничена, результат можно автоматически проверить, а ошибку легко откатить.
Быстрые прототипы и внутренние инструменты
Агент может за часы собрать форму, небольшой API, импорт CSV, внутренний дашборд или интеграционный proof of concept. В greenfield-проекте нет многолетнего слоя скрытых договорённостей, поэтому модель реже конфликтует с существующей архитектурой.
Но цель прототипа — проверить сценарий, а не доказать готовность к эксплуатации. До production обычно отсутствуют управление доступами, миграции данных, резервное копирование, мониторинг, ограничение нагрузки, обработка частичных отказов и инструкция поддержки.
Локальные функции с чётким контрактом
Хорошая задача звучит так: «Добавь endpoint экспорта, используй существующий сервис авторизации, не меняй схему БД, покрой три перечисленных случая тестами». Плохая — «сделай модуль отчётности».
Чем уже контракт и яснее примеры входа и выхода, тем меньше пространства для правдоподобного, но неверного решения.
Тесты, фикстуры и проверка граничных случаев
Агент быстро генерирует таблицы тестовых случаев, фикстуры и проверки ошибок. Полезно сначала зафиксировать ожидаемое поведение тестами и убедиться, что они падают на старой реализации. Затем дать агенту изменить код, запретив редактировать тесты.
Самогенерация тестов не гарантирует независимости: модель может написать проверку под собственную ошибочную интерпретацию. Критичные инварианты и примеры должны исходить из требований, инцидентов или человека, понимающего домен.
Исследование незнакомого репозитория
Coding-агент может найти точку входа, построить путь запроса, показать связанные конфиги и объяснить, где выполняется валидация. Это ускоряет онбординг и диагностику. Требуйте ссылки на файлы и символы: общее описание без проверяемых координат легко превращается в выдуманную архитектуру.
Повторяемые миграции малого радиуса
Переименование API, обновление однотипных вызовов, перевод конфигураций и исправление линтера хорошо автоматизируются, если изменение механическое и проверяется компилятором. Чем ближе задача к полной смене фреймворка или языка, тем выше риск частично работающей миграции.
Документация и подготовка ревью
Агент может описать публичный API, собрать changelog по diff, найти несоответствие комментариев коду и подготовить вопросы автору. Финальный текст всё равно должен проверить владелец компонента: модель видит реализацию, но не всегда знает, какие обязательства команда дала пользователям.
Почему быстрый прототип ещё не production
Главная иллюзия возникает в момент, когда интерфейс открывается, тестовая кнопка нажимается и разработка кажется завершённой. На самом деле демонстрация проверила только один счастливый путь.
Агент оптимизирует видимый критерий
Если задача оценивается прохождением существующих тестов, агент стремится сделать их зелёными. Это не то же самое, что сохранить архитектуру, производительность и смысл миграции. В августовском препринте SWE Refactor Bench агенты выполняли полные миграции репозиториев. Из 520 запусков только 28 прошли аудит факта миграции, фиксированные тесты и дополнительные проверки; лучший результат модели Claude Opus 5 составил 47 из 100.
Особенно показательно, что часть решений сохраняла поведение, фактически обходя требуемую миграцию. Это не «глупость модели», а нормальное следствие неверно заданной функции успеха.
Большой репозиторий полон невидимых контрактов
Тесты не всегда описывают совместимость с внешними клиентами, очередь событий, формат старых данных или ручную операцию поддержки. Разработчик узнаёт эти ограничения из инцидентов, обсуждений и истории решений. Агент видит только тот контекст, который нашёл или получил.
Поэтому изменение в mature-системе требует не просто больше токенов. Нужны архитектурные документы, runbook, схема данных, контрактные тесты, наблюдаемость и человек, который понимает последствия.
Скорость генерации переносит узкое место в ревью
В опросе Stack Overflow 2025 года 66% разработчиков назвали основной проблемой решения, которые «почти правильные», а 45% сообщили, что отладка сгенерированного кода занимает больше времени. Это самоотчёт, а не эксперимент, но он хорошо описывает типичную стоимость: синтаксически убедительный код заставляет проверяющего искать тонкую логическую ошибку.
Исследование METR 2025 года дало ещё более неудобный результат: 16 опытных open-source разработчиков на знакомых зрелых проектах выполняли задачи с AI на 19% дольше, хотя считали, что ускорились. Однако этот результат нельзя превращать в лозунг «ИИ замедляет всех». В обновлении от февраля 2026 года METR увидела слабые признаки ускорения с новыми агентными инструментами, но признала новую оценку ненадёжной: активные пользователи не хотели участвовать в задачах без AI, а выбор задач смещался.
Честный вывод скромнее: эффект зависит от поколения инструмента, типа задачи, зрелости проекта и качества измерения. Собственный пилот важнее универсального процента.
Чем быстрее команда генерирует код, тем важнее инженерная система
DORA в отчёте 2025 года описывает AI как усилитель: он увеличивает эффект уже существующих сильных и слабых сторон организации. Если у команды быстрые тесты, небольшие pull request, стабильное окружение и ясное владение компонентами, агент получает качественную обратную связь. Если сборка нестабильна, ревью формально, а инциденты не превращаются в тесты, AI просто производит больше изменений поверх слабого процесса.
Production-ready — это не характеристика текста кода. Это результат системы, где изменение проходит сборку, тестирование, security-проверку, наблюдение после релиза и имеет владельца.
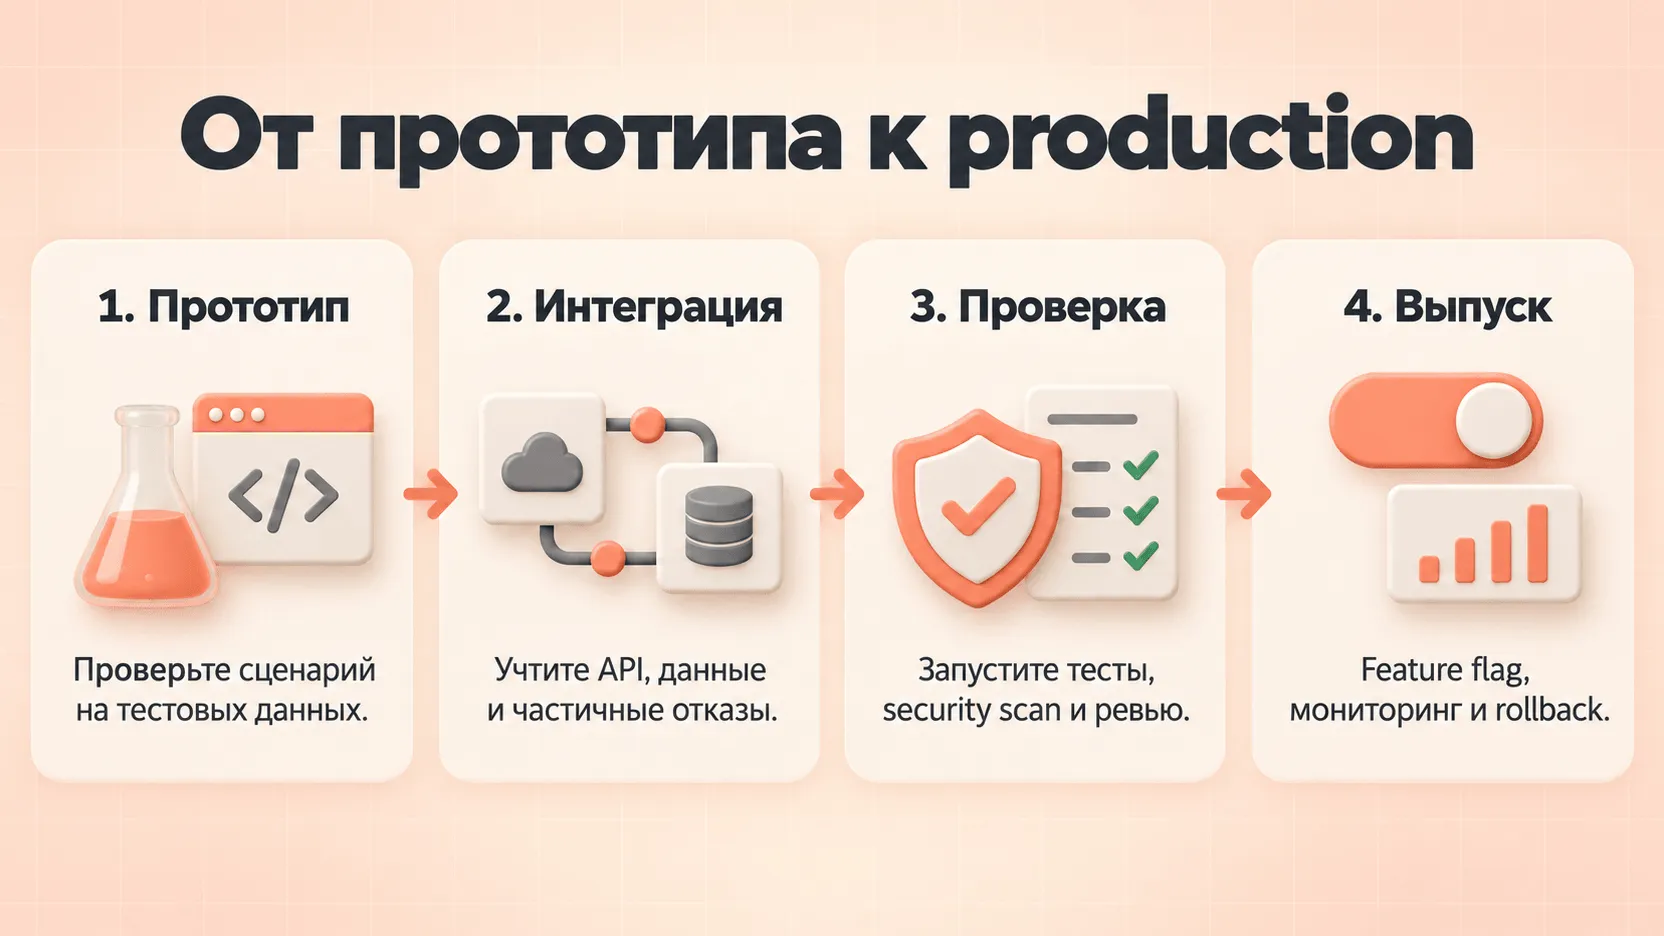
Прототип проверяет сценарий; production требует интеграции, независимой проверки, наблюдаемого выпуска и возможности отката.
Как поставить задачу coding-агенту
Фраза «добавь авторизацию» оставляет агенту слишком много решений. Хорошее задание похоже на небольшое техническое ТЗ и содержит девять элементов:
- Цель пользователя: что должно измениться в поведении продукта.
- Граница: какой модуль или маршрут можно менять.
- Исходный контекст: issue, воспроизведение, ссылки на файлы и решения.
- Инварианты: что должно остаться без изменений.
- Ограничения: запрещённые зависимости, миграции, сеть и действия.
- Критерии приёмки: конкретные примеры входа и результата.
- Проверки: команды тестов, линтера, типов и сборки.
- Формат отчёта: план, список файлов, diff, результаты команд и оставшиеся риски.
- Условия остановки: когда агент обязан задать вопрос.
Долгоживущие правила команды лучше вынести из разового задания в отдельный файл инструкций. Принципы такой конструкции подробно разобраны в материале про системные промпты.
Большой промпт для изменения существующего проекта
Ты работаешь как coding-агент в существующем репозитории. Сначала исследуй код и подготовь план; не меняй файлы до моего подтверждения.

Задача пользователя: при повторной отправке одного и того же платежного webhook система не должна создавать вторую операцию.

Контекст:
- точка входа: src/payments/webhook.ts;
- текущие тесты: tests/payments/webhook.test.ts;
- идентификатор события приходит в поле event_id;
- схема БД изменяться не должна;
- новую внешнюю зависимость добавлять нельзя.

Инварианты:
- первый корректный webhook обрабатывается как сейчас;
- повтор возвращает HTTP 200, но не создаёт новую операцию;
- подпись webhook проверяется до любой работы с event_id;
- логи не содержат payload и секрет подписи.

Проверки:
- npm test -- tests/payments/webhook.test.ts;
- npm run typecheck;
- npm run lint.

Сначала верни:
1. путь выполнения запроса с точными файлами и функциями;
2. найденный механизм хранения или причину, почему его нет;
3. минимальный план изменений;
4. тесты, которые сначала должны падать;
5. риски и вопросы.

Остановись, если без изменения схемы невозможно обеспечить идемпотентность или если event_id не считается уникальным по контракту провайдера.
Сокращённый пример хорошего первого ответа:
Путь запроса: router POST /webhooks/payments → verifySignature() → parseEvent() → paymentService.applyEvent(). Проверка подписи выполняется до parseEvent; это сохраняем.

В репозитории уже есть таблица processed_events и helper claimEvent(), который используется для webhook другого провайдера. Предлагаю переиспользовать его, поэтому миграция не нужна.

План:
1. Добавить два теста: повтор одного event_id и одинаковый event_id с неверной подписью.
2. Вызвать claimEvent() после verifySignature(), до создания операции.
3. При false вернуть 200 с кодом duplicate_event.
4. Запустить целевой тест, typecheck и lint.

Вопрос: уникален ли event_id глобально или только внутри merchant_id? Без ответа ключ идемпотентности неоднозначен. Файлы пока не менял.
Такой ответ ценен не объёмом, а тем, что агент нашёл существующий механизм и заметил доменный вопрос до реализации.
Восемь промптов для реальной работы с кодом
Эти шаблоны рассчитаны на агента, который действительно видит репозиторий и может выполнять команды. В обычном чате нужно вручную приложить необходимые фрагменты, а результаты тестов запускать самостоятельно.
1. Разобраться в незнакомом модуле
Исследуй путь запроса [сценарий] от точки входа до записи результата. Ничего не меняй. Покажи последовательность функций, файлов и внешних зависимостей. Для каждого вывода дай ссылку на файл и символ. Отдельно перечисли места, где информации недостаточно или поведение определяется конфигурацией.2. Подготовить план без кода
Составь минимальный план изменения для [задача]. Сначала найди аналогичные реализации и действующие правила проекта. Укажи изменяемые файлы, сохраняемые инварианты, необходимые тесты, риск миграции и способ отката. Не редактируй файлы до подтверждения плана.3. Воспроизвести баг
Наблюдение: [точные шаги и фактический результат]. Ожидание: [результат]. Сначала воспроизведи дефект существующей командой или создай минимальный падающий тест. Не исправляй код, пока не покажешь подтверждённую причину и не отделишь её от гипотез.4. Реализовать маленький diff
Реализуй согласованный план только в [разрешённые файлы или модуль]. Не меняй публичный API, зависимости и соседний рефакторинг. После каждого логического шага запускай [точная команда]. В конце покажи diff, результаты проверок и всё, что осталось непроверенным.5. Написать тесты до реализации
По требованиям ниже добавь тесты, которые фиксируют текущий контракт и новый случай. Сначала запусти их и подтверди: старые проходят, новый падает по ожидаемой причине. Реализацию и существующие assertions не меняй. Если требование неоднозначно, задай вопрос до теста.6. Провести независимое ревью diff
Проверь этот diff как независимый ревьюер. Не предлагай косметические правки. Ищи только ошибки корректности, безопасности, конкурентности, совместимости, обработки отказов и отсутствующие тесты. Для каждого замечания укажи файл, строку, воспроизводимый сценарий и почему текущие проверки его не ловят. Если критичных проблем нет, скажи это прямо.7. Выполнить рефакторинг с инвариантами
Нужно [рефакторинг]. Поведение, публичные типы, формат данных и порядок побочных эффектов должны сохраниться. Сначала зафиксируй инварианты тестами или существующими проверками. Делай изменение маленькими шагами. Не ослабляй тесты ради зелёной сборки. После завершения сравни до/после и перечисли непокрытые риски.8. Подготовить передачу человеку
Подготовь отчёт для ревьюера: цель изменения, принятые решения, изменённые файлы, выполненные команды и их результаты, известные ограничения, миграция и rollback, вопросы для ручной проверки. Не утверждай, что production готов, если не были выполнены [обязательные проверки].Рабочий процесс: исследование, план, маленький diff и независимая проверка
Для production-кода полезен не самый автономный режим, а наиболее управляемый цикл.
Шаг 1. Подготовьте репозиторий для человека и агента
Сборка должна запускаться одной документированной командой. Добавьте короткий AGENTS.md, CLAUDE.md или аналогичный файл с архитектурными границами, командами проверок, стилем и запретами. Не превращайте его в энциклопедию: длинные противоречивые инструкции ухудшают соблюдение правил.
Минимальный набор:
# Команды
- npm test -- <path>: целевые тесты
- npm run typecheck: проверка типов
- npm run lint: линтер

# Границы
- не менять migrations/ без отдельного согласования;
- не добавлять зависимости для задачи, решаемой стандартной библиотекой;
- не отправлять код, логи и данные во внешние сервисы;
- не коммитить .env и секреты.

# Готовность
- маленький diff;
- новые ветки поведения покрыты тестами;
- все выполненные и невыполненные проверки перечислены в отчёте.
Шаг 2. Дайте агенту прочитать, но не писать
Попросите найти путь выполнения, похожие реализации и места риска. На этом этапе дешевле исправить неверное понимание, чем удалять сотни строк кода. Для критичного компонента используйте read-only режим.
Шаг 3. Согласуйте план и критерии
План должен назвать файлы, тесты, инварианты и способ отката. Фраза «изменю сервис и обновлю тесты» недостаточна. Хороший план показывает, где именно находится правило и почему изменение минимально.
Шаг 4. Ограничьте размер изменения
Один pull request — одна проверяемая цель. Не объединяйте исправление бага, обновление зависимостей и массовый рефакторинг. Агент легко расширяет задачу, потому что соседнее улучшение кажется логичным. Для ревьюера это увеличивает неопределённость.
Шаг 5. Выполните автоматические проверки
Минимум — целевые тесты, полный набор релевантных тестов, статический анализ и сборка. Для API добавьте контрактные тесты, для данных — миграционный прогон на копии, для интерфейса — визуальную и accessibility-проверку, для конкурентного кода — нагрузочный или race test.
Шаг 6. Отделите автора от проверяющего
Попросите другой контекст, модель или человека проверить diff. Один и тот же агент склонен защищать собственное решение и повторять исходное допущение. Независимому ревьюеру передайте требования и diff, но не убеждающее объяснение автора.
Шаг 7. Выпускайте обратимо
Используйте feature flag, ограниченный rollout, миграцию с обратной совместимостью и мониторинг новых ошибок. Агент может помочь подготовить эти механизмы, но решение о выпуске принимает владелец системы.
Безопасность: coding-агент получает больше, чем текст промпта
Агент с shell видит файлы, выполняет программы и иногда имеет сетевой доступ. Ошибка в настройке может быть опаснее неверной функции.
Начинайте с минимальных разрешений
Для исследования достаточно чтения. Для реализации разрешите запись только в workspace. Удаление файлов, установка системных пакетов, доступ к сети, публикация и работа с production должны требовать отдельного подтверждения или быть технически запрещены.
OpenAI и Anthropic документируют sandbox и политики подтверждения именно потому, что универсальный режим «выполняй всё без вопросов» небезопасен. Если автономный запуск действительно нужен, используйте отдельный контейнер или VM без лишних данных и с ограниченной сетью.
Не передавайте production-секреты в обычный контекст
Агенту редко нужен настоящий ключ от базы или облака. Для теста используйте короткоживущие учётные данные, mock или отдельный стенд. Секреты должны вводиться через защищённый механизм среды и не попадать в промпт, логи, diff и commit.
Считайте содержимое репозитория недоверенным вводом
README, issue, dependency и веб-страница могут содержать инструкции, которые пытаются заставить агента выполнить внешнее действие. Это prompt injection в контексте инструментов. Ограничение исходящего трафика, allowlist доменов и подтверждение критичных команд важнее обещания модели «игнорировать вредные указания».
Облачный и локальный режимы несут разные риски
Локальный агент работает рядом с файлами и учётными данными разработчика. Облачный агент требует передать репозиторий и окружение поставщику, но может быть лучше изолирован от ноутбука. У Cursor Cloud Agents, например, отдельные VM и настраиваемые ограничения сети, однако история разговоров и снимки окружения имеют собственные сроки хранения. Выбор зависит от политики компании; универсально «более безопасного» режима нет.
Сохраняйте следы работы
Для каждой задачи должны остаться промпт или issue, план, diff, выполненные команды, результаты тестов и автор финального одобрения. Это позволяет расследовать дефект и улучшить правила. Без журнала агент превращается в неизвестного автора с очень высокой скоростью.
Как провести пилот и измерить пользу команды
Не начинайте с метрики «сколько процентов кода написал ИИ». Больше строк может означать больше дублирования и работы на ревью.
Соберите репрезентативный набор задач
Включите 10–20 задач разных типов:
- локальный баг с воспроизведением;
- небольшая функция;
- тесты для известного контракта;
- обновление документации;
- механический рефакторинг;
- задача с неполным требованием, где агент должен остановиться;
- задача, которую сознательно нельзя отдавать автономно.
Не подбирайте только красивые демо. Цель пилота — найти границу, а не доказать заранее выбранный результат.
Зафиксируйте baseline
Для похожих прошлых задач оцените календарное время, активное время разработчика, количество итераций ревью, дефекты после слияния и время до отката. Затем измеряйте тот же набор с агентом.
Считайте полный цикл
Полезные метрики:
| Метрика | Что показывает | Ловушка |
|---|---|---|
| Время до первого рабочего diff | Скорость старта | Быстрый diff может быть далёк от принятия |
| Активное время разработчика | Реальную экономию внимания | Фоновое ожидание не равно бесплатной работе |
| Итерации до принятия | Качество постановки и результата | Число циклов без оценки их размера малоинформативно |
| Доля diff, переписанная человеком | Степень полезности агента | Небольшая правка может менять всю архитектуру |
| Дефекты и rollback после слияния | Качество доставки | Нужен достаточный период наблюдения |
| Стоимость модели и инфраструктуры | Экономику | Цена токена не отражает количество повторных запусков |
| Понимание владельцем изменения | Поддерживаемость | Трудно измерить автоматически, но критично для on-call |
Сравнивайте инструменты на одинаковом definition of done. Если один агент только пишет код, а другой ещё запускает integration tests, их время нельзя сопоставлять без нормализации.
Введите три зоны автономности
- Зелёная: документация, тестовые фикстуры, локальные прототипы, обратимые изменения с сильными проверками.
- Жёлтая: бизнес-логика, миграции, зависимости, публичный API — агент работает, человек утверждает план и diff.
- Красная: production-доступ, платежи, безопасность, удаление данных, права пользователей и необратимые операции — только ограниченный контур и явное подтверждение ответственного.
После пилота обновите правила не только для агента, но и для репозитория. Если задача провалилась из-за неописанной команды сборки или неявного контракта, это долг документации команды.
Что остаётся человеку, когда агент пишет большую часть кода
Человек меньше набирает символы, но не исчезает из процесса. Его работа смещается к формулировке проблемы, выбору компромиссов и проверке последствий.
Исследование Anthropic примерно 400 000 сессий Claude Code показало характерное разделение: люди чаще решали, что делать, а агент — как выполнить задачу. Более высокая доменная экспертиза пользователя была связана с большей успешностью. Это вендорское исследование собственного продукта, поэтому его нельзя считать доказательством для всего рынка, но вывод практически правдоподобен: знание предметной области не заменяется скоростью генерации.
Разработчик и команда всё ещё отвечают за:
- цель продукта и приоритет задачи;
- архитектурные границы и доменную модель;
- выбор между скоростью, стоимостью, надёжностью и безопасностью;
- полноту критериев приёмки;
- независимое ревью и выпуск;
- реакцию на инцидент и долгосрочное сопровождение.
Особенно опасно, когда никто не может объяснить сгенерированный модуль. Код без владельца работает до первого нетипичного сбоя. Правило простое: человек, который принимает pull request, должен уметь поддерживать его без продолжения того же чата.
Для junior-разработчика агент может быть наставником и генератором примеров, но также скрыть пробелы. Если начинающий сотрудник принимает код по принципу «тесты зелёные», он не учится видеть архитектуру и отказоустойчивость. Полезнее просить агента объяснить решение, предложить альтернативы и задать вопросы, а не только выдать готовый diff.
Что можно сделать с кодом в обычном чате Agent Roi
Agent Roi в текущем сценарии — чат с frontier-моделями, а не coding-агент с доступом к вашему компьютеру. Это важно обозначить честно.
В чате можно:
- описать задачу и получить варианты архитектуры;
- подготовить техническое задание для Claude Code, Codex, Cursor или другого агента;
- разобрать небольшой вставленный фрагмент кода или ошибку;
- написать SQL, формулу, регулярное выражение или локальную функцию;
- составить тестовые случаи и чек-лист ревью;
- сравнить два подхода и выявить недостающие требования;
- подготовить
AGENTS.md,CLAUDE.mdили системные правила проекта.
Чат без внешних инструментов не может самостоятельно прочитать десятки тысяч файлов, запустить сборку, изменить репозиторий, открыть браузер, проверить интерфейс и подтвердить, что код работает. Большой проект нужно либо разбирать по выбранным фрагментам, либо передавать специализированному агенту с разрешённым доступом к репозиторию и среде.
Практичная связка выглядит так:
- В Agent Roi формулируют требования, инварианты и критерии приёмки.
- Coding-агент исследует репозиторий и предлагает план.
- Человек согласует план и ограничивает область изменения.
- Агент реализует, запускает проверки и возвращает diff.
- Человек или независимый агент проводит ревью.
Так чат не изображает инструмент, которого у него нет, а помогает повысить качество постановки и проверки.
FAQ
Может ли ИИ полностью написать приложение?
Он может самостоятельно собрать прототип и даже небольшой рабочий сервис, если требования ограничены, окружение воспроизводимо, а критерии проверяются автоматически. Для production остаются архитектура, безопасность, эксплуатация, нагрузка, миграции, наблюдаемость и ответственность за выпуск. Чем выше цена ошибки и срок жизни системы, тем меньше смысла говорить о «полностью» автономной разработке.
Какая модель лучше для программирования в сентябре 2026 года?
Для сложных агентных задач актуальны Claude Fable 5.1 и Opus 5, GPT-5.3-Codex, Claude Sonnet 5 и специализированные модели оболочек вроде Composer 2.5. Но универсального победителя нет: итог зависит от harness, окружения, tool use, effort, стоимости и конкретного репозитория. Проверяйте кандидатов на собственном наборе задач.
Что выбрать: Claude Code, Codex или Cursor?
Claude Code и Codex удобны как терминальные агенты с глубоким доступом к рабочему окружению. Cursor объединяет редактор, агентный режим, множество моделей и облачные задачи. Выбор определяется тем, где хранится код, какие разрешения допустимы, нужен ли фоновой режим и насколько команда готова настраивать окружение. Начните с двух инструментов и одинакового пилотного набора.
Подойдёт ли Hermes Agent для программирования?
Да, Hermes можно подключить к сильной coding-модели, дать ему файловые и терминальные инструменты или поручить вызывать специализированного coding-агента. Но Hermes — общий агент с памятью, навыками, каналами и автоматизациями, а не готовая вертикальная IDE. Без настройки прав и workflow он не становится безопасным production-разработчиком автоматически.
Можно ли доверять коду, если все тесты проходят?
Нет. Зелёные тесты подтверждают только проверенные сценарии. Агент мог неверно понять требование, изменить тест, обойти смысл миграции или нарушить нефункциональный контракт. Нужны независимое ревью, анализ diff, security-проверки, тесты интеграций и контролируемый выпуск.
Нужен ли разработчик, если заказчик умеет хорошо ставить задачи агенту?
Для одноразового прототипа иногда достаточно сильного специалиста предметной области. Для долгоживущей системы нужен человек, который понимает архитектуру, зависимости, эксплуатацию и последствия изменений. Умение написать хороший промпт не заменяет способность принять технический риск.
Как начать без лишнего риска
Выберите одну обратимую задачу, которая занимает у разработчика несколько часов и заканчивается проверяемым diff. Подготовьте команды сборки и тестов, задайте агенту режим «сначала исследование и план», а затем измерьте не количество сгенерированных строк, а полный путь до принятого изменения.
Если у вас пока нет coding-агента, начните в Agent Roi с подготовки технического задания: опишите сценарий, ограничения и критерии приёмки, попросите найти неоднозначности и собрать промпт для выбранного инструмента. После этого передайте задание Claude Code, Codex, Cursor или другому агенту с доступом к тестовому репозиторию — и оставьте финальное решение человеку, который будет поддерживать код.
Больше материалов по теме — в разделе «ИИ-агенты, автоматизация и разработка».